Выгрузка истории чата через Telegram API в браузере: было 29 минут, стало две с половиной
- среда, 28 октября 2026 г. в 00:00:07
Я делаю сайт, который считает статистику переписки прямо в браузере. Обычно для этого нужен экспорт чата Telegram из Desktop, а с телефона его не сделать. Поэтому у меня есть второй путь, без компьютера и без файла. Человек входит со своего телефона, а страница сама выкачивает историю выбранного чата через Telegram API, то есть MTProto, как настоящий клиент. Работает это на mtcute поверх WebSocket к серверам веб-клиента Telegram, со своими api_id и api_hash с my.telegram.org.
Три недели всё работало, но медленно. Я посмотрел в свою аналитику. Чат на 100–250 тысяч сообщений выгружался в среднем 33 минуты, а самый долгий занял 100. Всё это время человек должен держать вкладку открытой с горящим экраном, потому что в фоне телефон останавливает загрузку. Почти три четверти всего ожидания приходилось на большие чаты, хотя их всего пятая часть.
Потом я сам выгрузил с телефона переписку на 52 тысячи сообщений, и страница честно написала, что осталось около 29 минут.
Сегодня тот же чат выгружается за две с половиной. Ниже по порядку, что я перепробовал и что из этого реально сработало. Спойлер. Сработало не то, на что я больше всего надеялся.
История в Telegram отдаётся методом messages.getHistory по 100 сообщений за раз, листать нужно от новых к старым, передавая offset_id последнего полученного. Если спрашивать слишком часто, сервер отвечает FLOOD_WAIT_N и просит подождать N секунд. В первой версии я сделал паузу 300 мс между страницами, а после каждого такого ответа удваивал её, до двух секунд.
Посчитаем. 1500 страниц, ответ сервера около 0,2 с, пауза после пары «подождите» уже 1,2 с. Выходит 1500 × 1,4 ≈ 35 минут, почти ровно медиана из аналитики. Ошибка видна сразу. Пауза только росла и никогда не уменьшалась. Один неудачный момент в начале, и дальше весь чат ползёт на минимальной скорости.
Вторую вещь я заметил, только когда полез в исходники mtcute. По умолчанию там стоит floodWaiter с порогом 10 секунд, и все FLOOD_WAIT короче он пережидает сам и молча повторяет запрос. Мой код видел только длинные паузы. Получается, счётчик просьб подождать в моей аналитике показывал далеко не всё. Порог можно выключить на конкретный запрос:
const res = await client.call(request, {
  floodSleepThreshold: 0, // не ждать молча, отдавать FLOOD_WAIT нам
  abortSignal: signal,    // «Остановить» обрывает и запрос в пути
});
С таким вызовом я наконец увидел реальную картину на своём телефоне. Telegram не попросил подождать ни разу. Пауза между страницами 300 мс. А страница при этом шла три с половиной секунды.
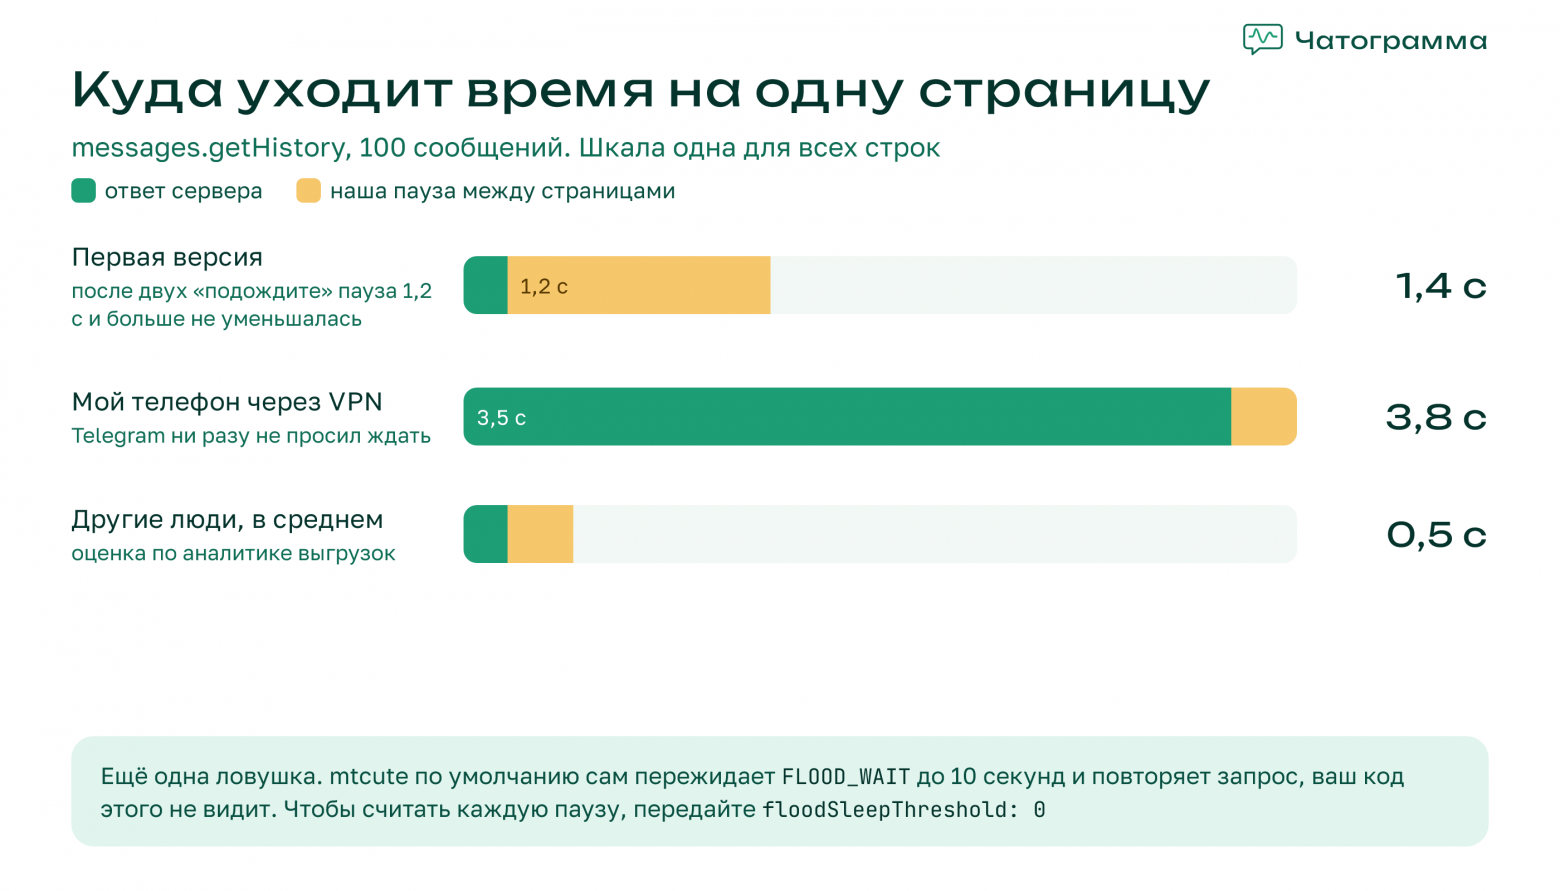
То есть почти всё время уходило на сам ответ сервера. У других людей, судя по той же аналитике, чистый ответ занимает около 0,2 с на страницу, а у меня вышло примерно в 15 раз дольше. На телефоне у меня включён VPN, и, видимо, дело в нём (дальний сервер, большая задержка). Но тогда я об этом ещё не думал и пошёл чинить ограничения, которых, как оказалось, не было.
У Telegram есть официальный механизм экспорта, через него работает «Экспорт истории» в Desktop. Открываешь сессию account.initTakeoutSession, оборачиваешь каждый запрос в invokeWithTakeout, и, если верить документации Telethon, лимиты становятся мягче. Сколько именно, Telegram не пишет.
Сразу открыть такую сессию не получится. Если вход свежий (а у меня он всегда свежий, человек только что ввёл код), сервер отвечает TAKEOUT_INIT_DELAY и шлёт на все устройства служебное сообщение о запросе экспорта. Под ним есть кнопка «Разрешить». Нажал на телефоне, вернулся во вкладку, и следующая попытка открывает сессию сразу. Я сделал так. Выгрузка большого чата (от 10 тысяч сообщений) идёт обычным путём, а страница показывает плашку с просьбой нажать «Разрешить» и раз в 20 секунд, плюс каждый раз при возвращении на вкладку, пробует открыть takeout. Открылся, и со следующей страницы запросы идут через него.
Чаще спрашивать не стал. Каждый initTakeoutSession на свежем входе может прислать ещё одно служебное сообщение, и заваливать человеку чат «Telegram» не хотелось. Сколько их приходит на самом деле при таком опросе, я, если честно, не считал.
Первая версия с takeout не ускорила ничего. Я полез в исходники экспорта Telegram Desktop и нашёл два отличия. Desktop сначала запрашивает messages.getSplitRanges, получает диапазоны id сообщений и оборачивает каждый getHistory ещё и в invokeWithMessagesRange. Документация просит того же. Второе отличие в том, что пауз между страницами там нет совсем, единственная константа задержки закомментирована.
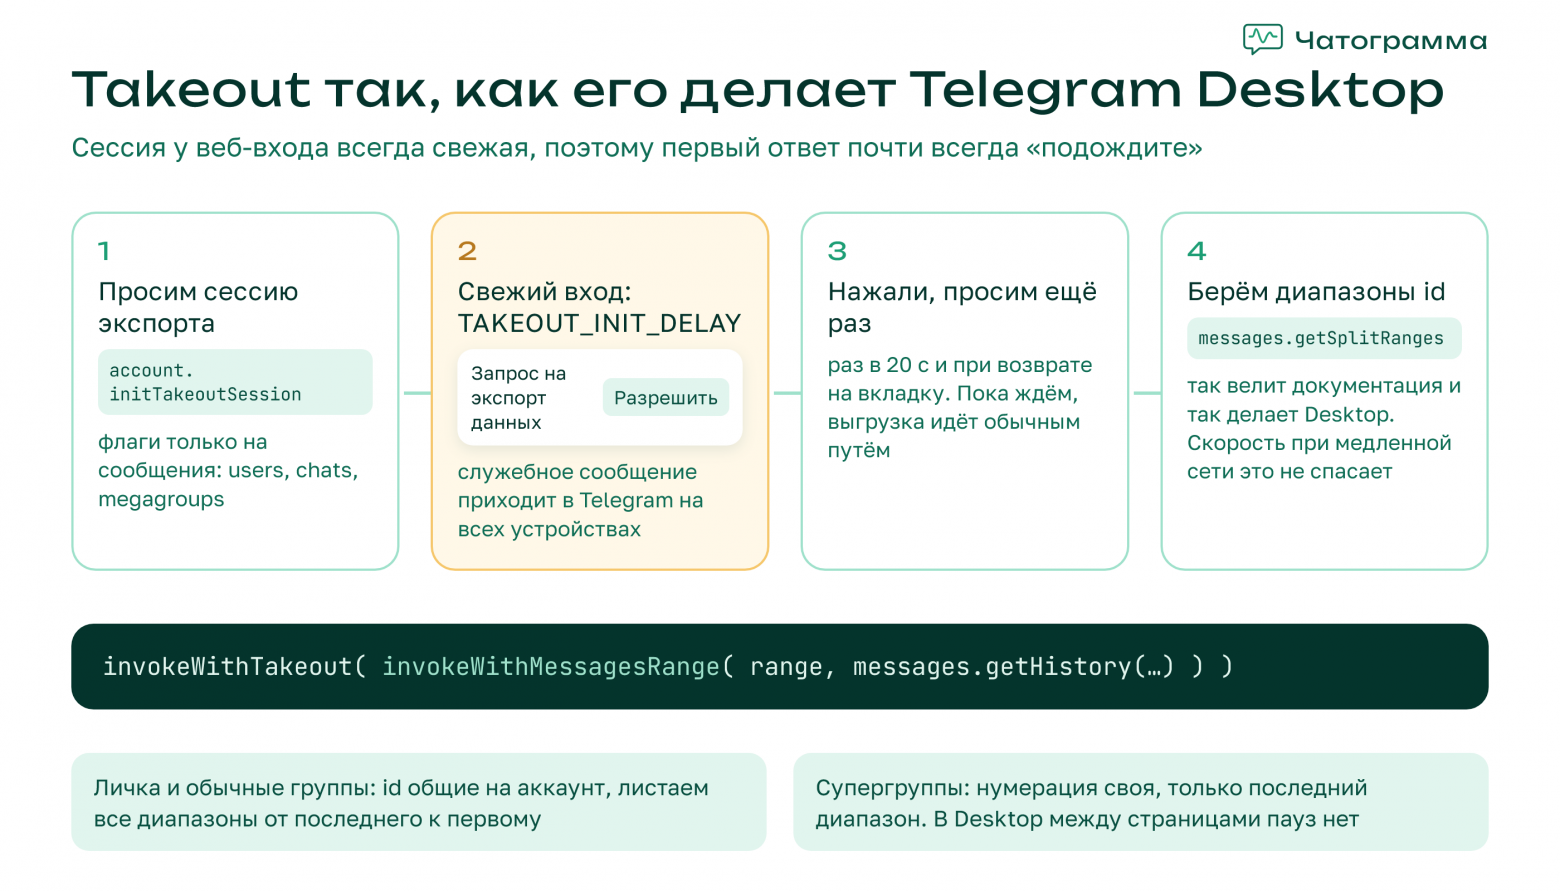
В mtcute обёртка уже есть, это параметр withMessageRange:
const session = await client.initTakeoutSession({
  messageUsers: true, messageChats: true, messageMegagroups: true,
});
const splits = await session.call({ _: 'messages.getSplitRanges' });

const res = await session.call(request, {
  floodSleepThreshold: 0,
  withMessageRange: splits[range],
});
Есть тонкость с диапазонами. Id сообщений в личных чатах и обычных группах общие на весь аккаунт, поэтому чат приходится листать по всем диапазонам, от последнего к первому. Если в диапазоне кончились сообщения, переходишь к предыдущему. У супергрупп нумерация своя, и Desktop берёт для них только последний диапазон. Я сделал так же. Кстати, если в супергруппе пройти по всем диапазонам, ничего страшного не случится, просто будет несколько пустых ответов, но зачем.
Помогло?
Честно говоря, почти нет. Через takeout с диапазонами страница у меня шла те же три с половиной секунды. Логично, если время съедает сеть. Takeout снимает ограничения на число запросов, а я в них не упирался.
Если один запрос идёт три секунды и сервер не жалуется, напрашивается очевидное. Слать несколько запросов одновременно.
Только offset_id следующей страницы неизвестен, пока не пришла предыдущая. Тут выручает add_offset. Он пропускает указанное число сообщений от offset_id, так что от одной точки можно разом попросить страницы 0–99, 100–199, 200–299 и так далее. Пришли все, и новой точкой становится последнее сообщение последней полной страницы. Если какая-то страница пришла неполной, значит, история (или диапазон takeout) кончилась, и остальные ответы пачки можно выбросить.
const pages = await Promise.allSettled(
  Array.from({ length: width }, (_, i) =>
    send({ ...request, offsetId: anchor, addOffset: i * 100 }, {
      kind: i > 0 ? 'download' : undefined, // свой WebSocket на страницу
    }),
  ),
);
Второй вопрос, по какому соединению их слать. Можно по одному, MTProto спокойно держит несколько запросов в полёте. Но у mtcute есть пул соединений для загрузки файлов (kind: 'download'), и туда можно отправить любой RPC, а не только upload.getFile. Размер пула задаётся через connectionCount, я поставил восемь. Если задержка набегает на каждое соединение отдельно, несколько соединений должны помочь сильнее, чем несколько запросов в одном. Сравнивать эти два варианта отдельно я не стал, сразу сделал с пулом.
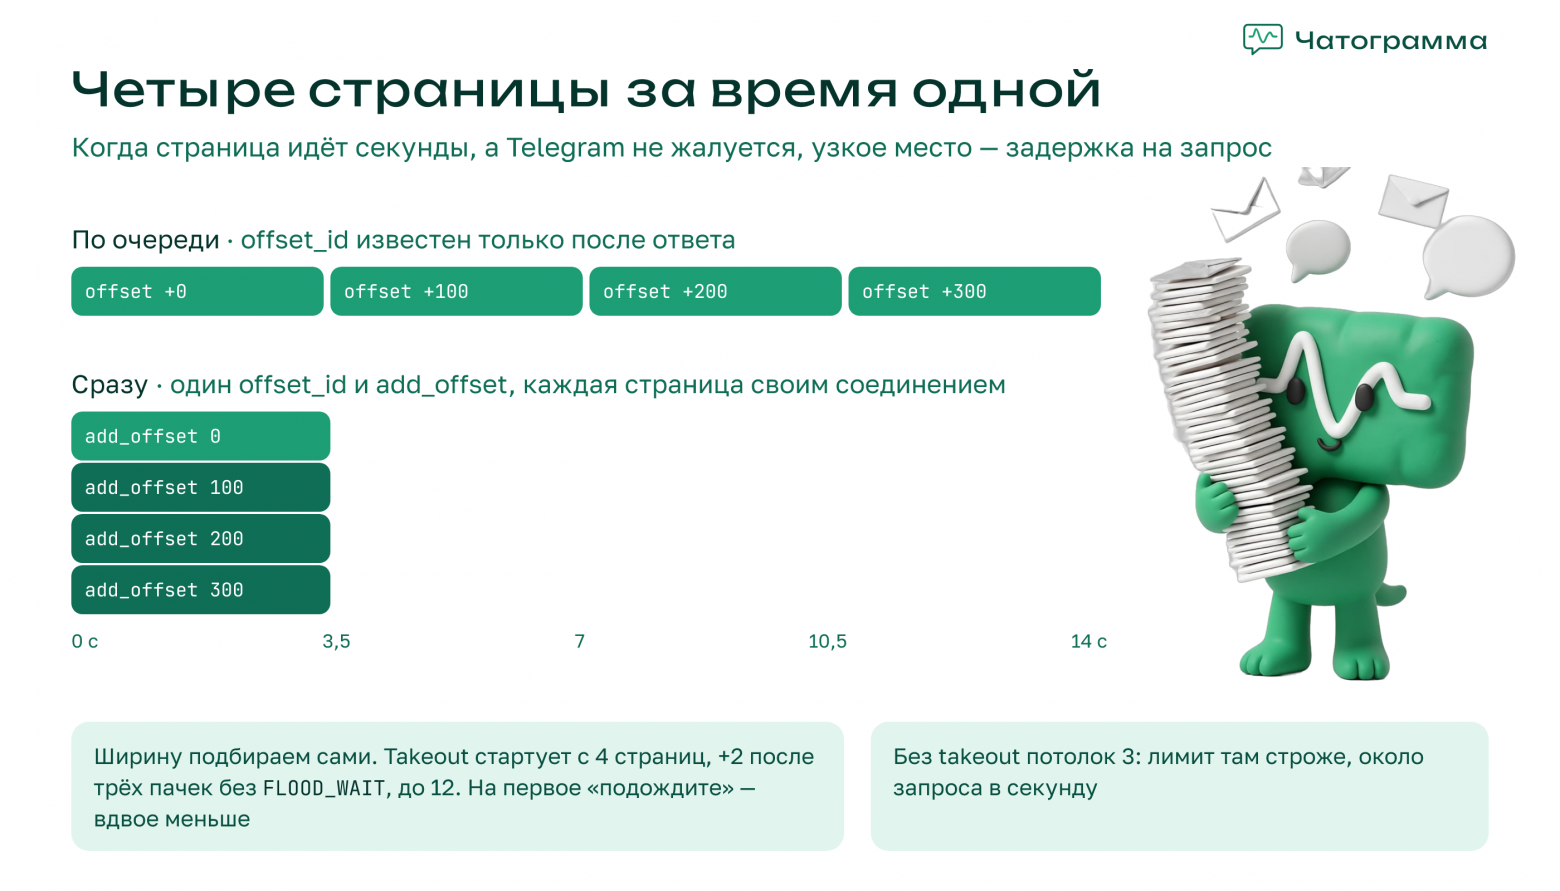
Сколько страниц просить сразу? Я не знаю реального лимита и, кажется, никто снаружи не знает. Поэтому ширина подстраивается сама. Takeout стартует с четырёх страниц. После трёх пачек подряд без FLOOD_WAIT ширина растёт на две, до двенадцати, а на первое же «подождите» падает вдвое. Без takeout потолок три, там лимит заметно строже, около запроса в секунду. Так пишут авторы Telethon в коде iter_messages, где по умолчанию стоит wait_time в секунду для больших чатов, и у меня похоже.
И пауза теперь тоже оттаивает: после «подождите» она удваивается, как раньше, но после 20 спокойных страниц уменьшается на пятую часть. Сначала я считал эти 20 по пачкам, а при ширине 12 это растягивалось на минуты. Пришлось считать по страницам.
Вот что вышло на том же чате с того же телефона.
Как выгружали | Ответ сервера | На страницу |
|---|---|---|
по одной странице, обычный путь | ~3,5 с | ~3,5 с |
по одной, через takeout с диапазонами | ~3,4 с | ~3,4 с |
по две, обычный путь | ~2 с | ~1 с |
по четыре, через takeout | ~1,4 с | ~350 мс |
разгон до двенадцати, через takeout | ~0,4 с | ~200 мс |
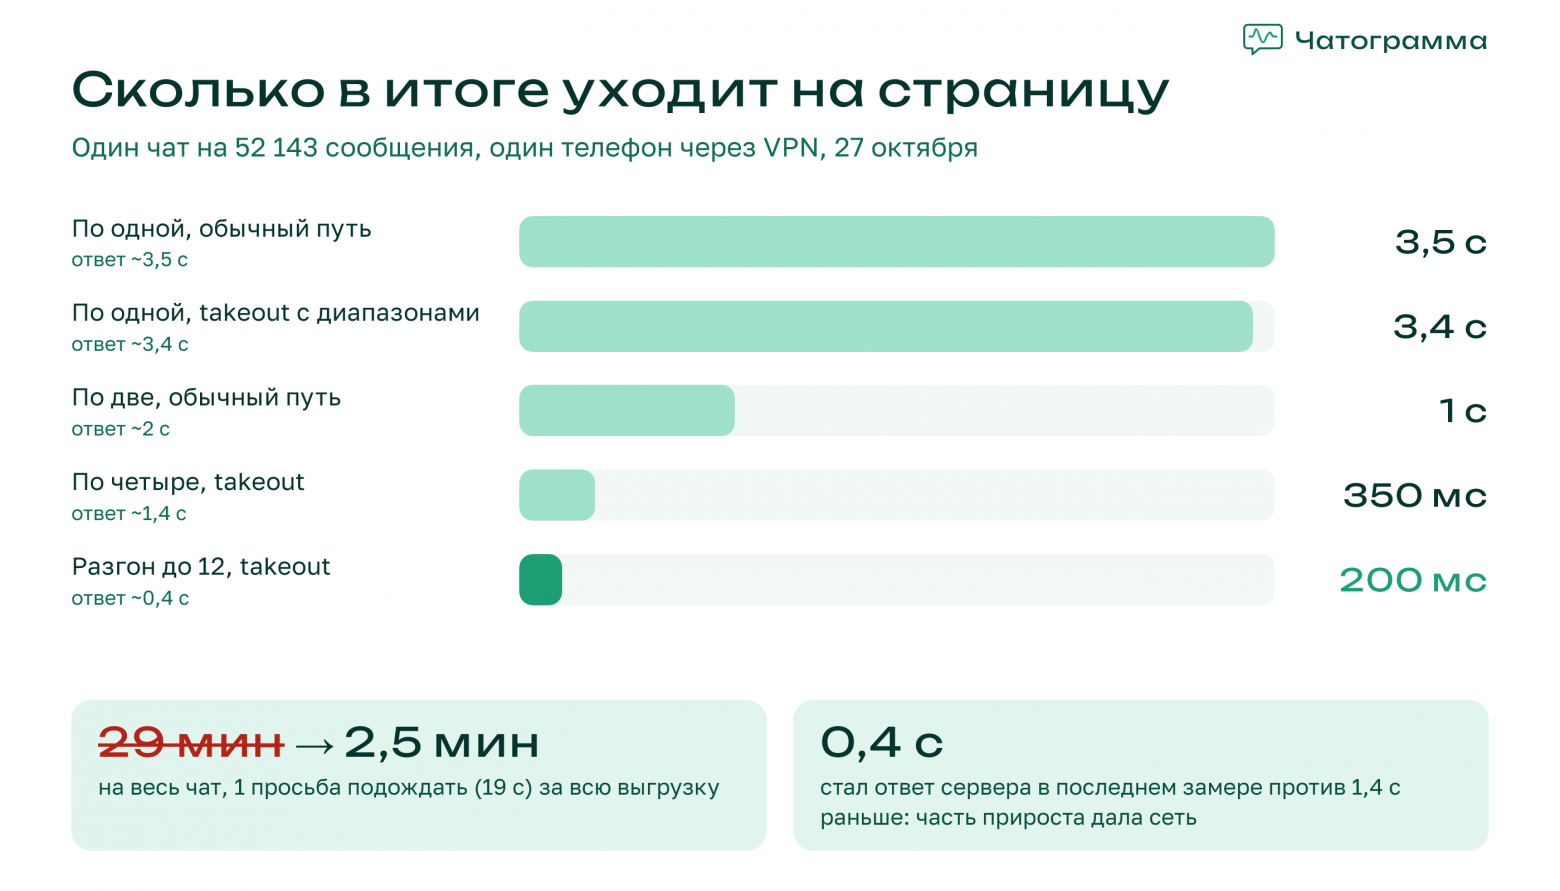
52 тысячи сообщений за две с половиной минуты, вместо 29. Telegram за всю выгрузку один раз попросил подождать 19 секунд, ширина после этого упала и снова разогналась. Последняя строка, правда, не совсем честное сравнение. Ответ сервера там вдруг стал 0,4 с вместо 1,4, похоже, VPN в тот момент работал быстрее. Так что часть прироста подарила сеть, и сколько именно, я сказать не могу. На компьютере без телефона, по входу через QR, получилось так же быстро.
Обычный путь без «Разрешить» тоже ускорился в несколько раз, но до takeout ему далеко: там больше трёх страниц сразу лучше не просить. Так что плашку с просьбой нажать кнопку я оставил главным советом на экране.
Вторая половина работы была о повторной выгрузке. Человек посчитал чат в октябре, а в декабре хочет итоги года. Зачем снова тянуть 150 тысяч сообщений, если новых там от силы тысяч пять?
Я стал сохранять переписку Telegram прямо на устройстве, в IndexedDB, сжатую через CompressionStream('gzip'). Получается около 40 байт на сообщение, тот самый чат на 52 тысячи занимает 1,9 МБ. На сервер копия не уходит, и для людей это важно. При обновлении страница качает от новых сообщений к старым, пока не дойдёт до последнего сообщения копии минус два дня.
Почему не ровно с последнего? Потому что сообщения правят и удаляют, а ещё сообщение, от которого считаешь, тоже могут удалить. Поэтому два дня перекрытия я заменяю целиком свежей версией из Telegram, ничего не сшивая по сообщениям. Всё, что старше, берётся из копии как было. Удалённое за эти дни пропадёт, исправленное обновится, дубликатов не будет просто по построению.
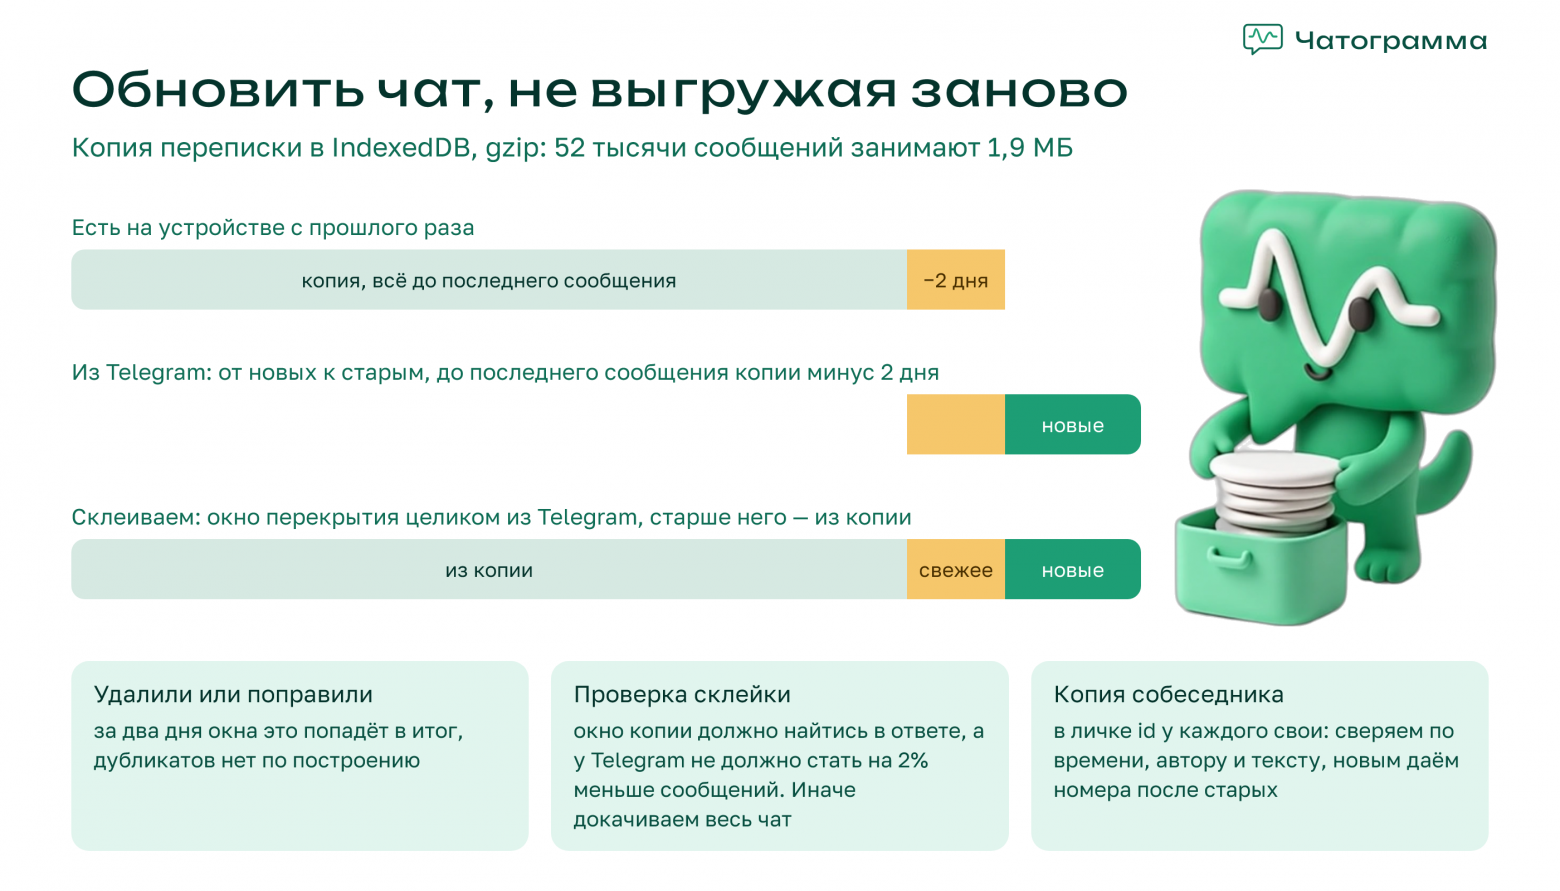
Склейке нельзя верить вслепую, и проверок у меня две. Сообщения окна из копии должны найтись в ответе Telegram хотя бы наполовину. А если у Telegram сообщений в чате заметно меньше, чем у меня (больше чем на 2 % и 20 штук), значит, историю почистили. В обоих случаях страница просто докачивает чат целиком с того же места.
Отдельный сюрприз преподнесли личные чаты. Копию мог сделать собеседник, файлом экспорта Desktop. А id сообщений в личке у каждого из двоих свои, у меня сообщение может быть номер 5000, а у него то же самое сообщение, скажем, номер 31 000. Тогда сравниваю по содержимому (время до секунды, автор, текст), а новым сообщениям даю номера после старых. Ответы на сообщения из окна при этом сохраняют свою связь, на более старые теряют.
Обновление чата, где за пару часов ничего не написали, у меня заняло одну страницу и 415 мс. Неделя переписки, по моей оценке, докачивается за несколько секунд.
Ещё одна грабля, на которой я потерял полдня. Страница входа передаёт выгрузку основной странице через Cache Storage, и та, забрав файл, сразу удаляет его из кэша. Разбор успевал файл прочитать. А вот копию для обновления я делал из того же файла позже, и в Safari на iPhone она молча не сохранялась. Похоже, после удаления из кэша второй раз такой Blob прочитать уже нельзя. В Chromium всё работало, поэтому на компьютере я ничего не заметил. Теперь копия сжимается сразу на странице входа, пока строка ещё в памяти. Может, кто-то сталкивался и знает, где это описано? Я так и не нашёл.
И мелочь напоследок. Кнопка «Остановить» срабатывала через 5–7 секунд и не с первого нажатия. Отмена проверялась только между страницами, а запрос в пути и пауза доживали до конца. Помог тот же abortSignal в параметрах вызова (он есть выше в первом примере) и проверка signal.aborted перед паузой.
Что осталось непонятным. Сколько одновременных запросов выдерживает takeout на самом деле? У меня двенадцать прошли почти без пауз, но это один аккаунт и один вечер. И даёт ли сам takeout что-то при хорошей сети, где упираешься уже в лимиты, а не в задержку. Если кто-то мерил, мне было бы очень интересно сравнить.