Почему мы забрали у LLM браузер: 8 выводов после года работы над расширением для промокодов
- суббота, 24 октября 2026 г. в 00:00:14
Изначально отдали GPT полный контроль: вот тебе страница магазина, вот список промокодов, разбирайся. На демо это выглядело хорошо. Ровно до того дня, когда он зашел на страницу оформления, увидел заполненную форму, прикинул, что задача выглядит примерно так, и двинулся нажимать кнопку покупки. Формально он выполнял инструкцию. Фактически мы в этот момент поняли, что полный контроль над чужим браузером LLM давать нельзя. Да и в релизе это было дорого, нестабильно и оказалось местами опасно.
Почти каждая деталь этой системы появилась после того, как что-то сломалось на проде. Так что дальше в основном собраны истории провалов. Предлагаю вашему вниманию разбор в деталях и наши выводы про построение AI-native продуктов.
Сейчас это расширение само ищет и применяет промокоды на тысячах онлайн магазинов по всему миру.
На знакомых сайтах обработка стоит ноль, на незнакомых менее 0,5 цента. LLM внутри при этом делает до обидного мало: он показывает пальцем, где на странице поле для купона, кнопка и итоговая сумма. Кликает, печатает и сверяет цену уже обычный скрипт, который мы можем покрыть тестами.
Что вообще делает расширение
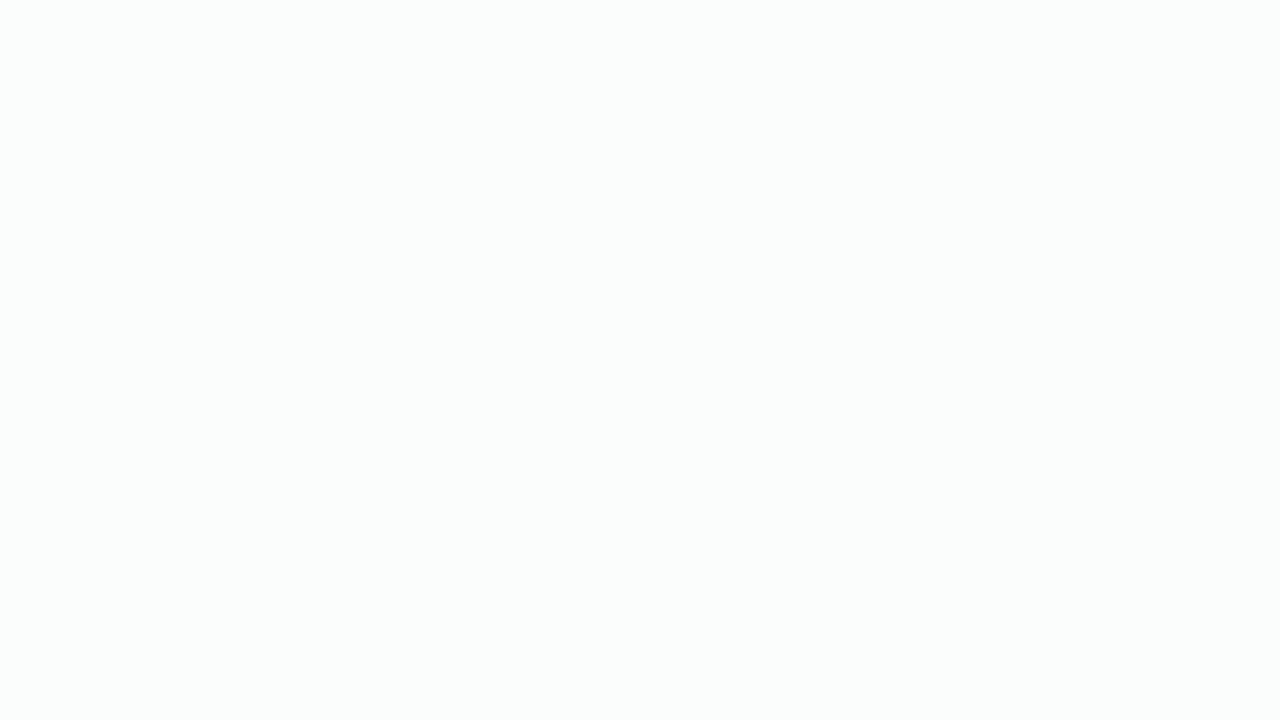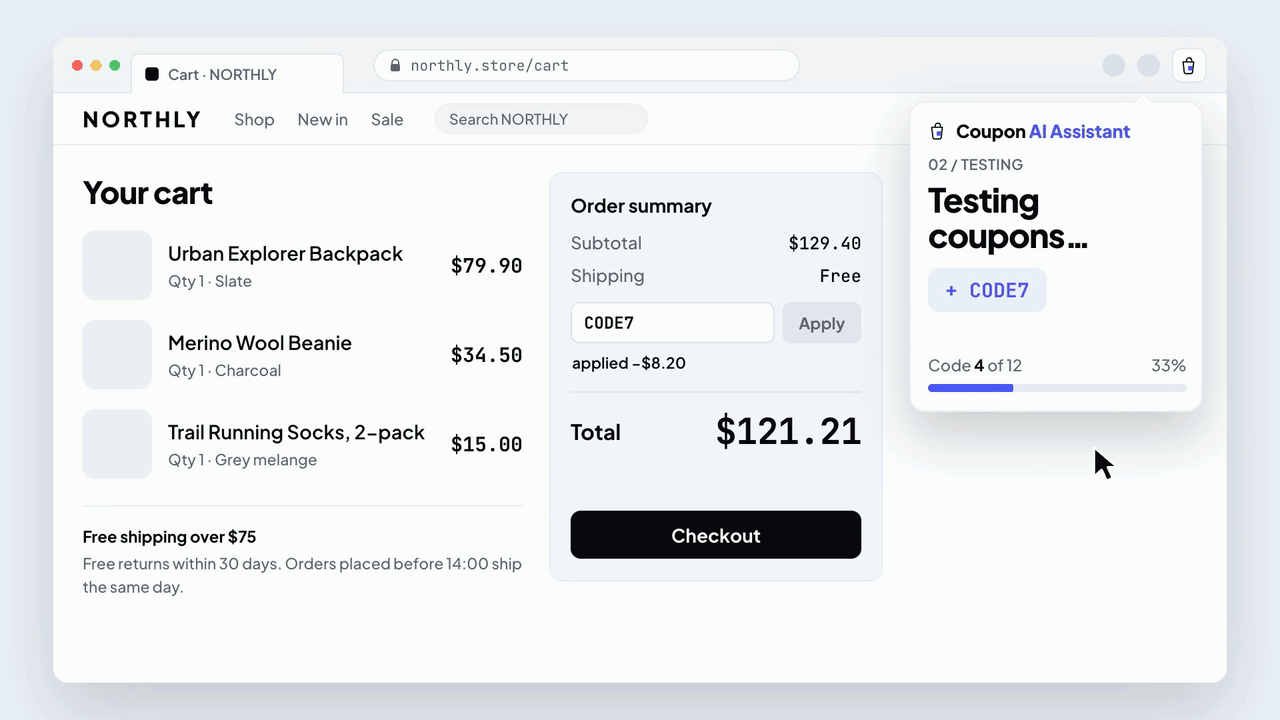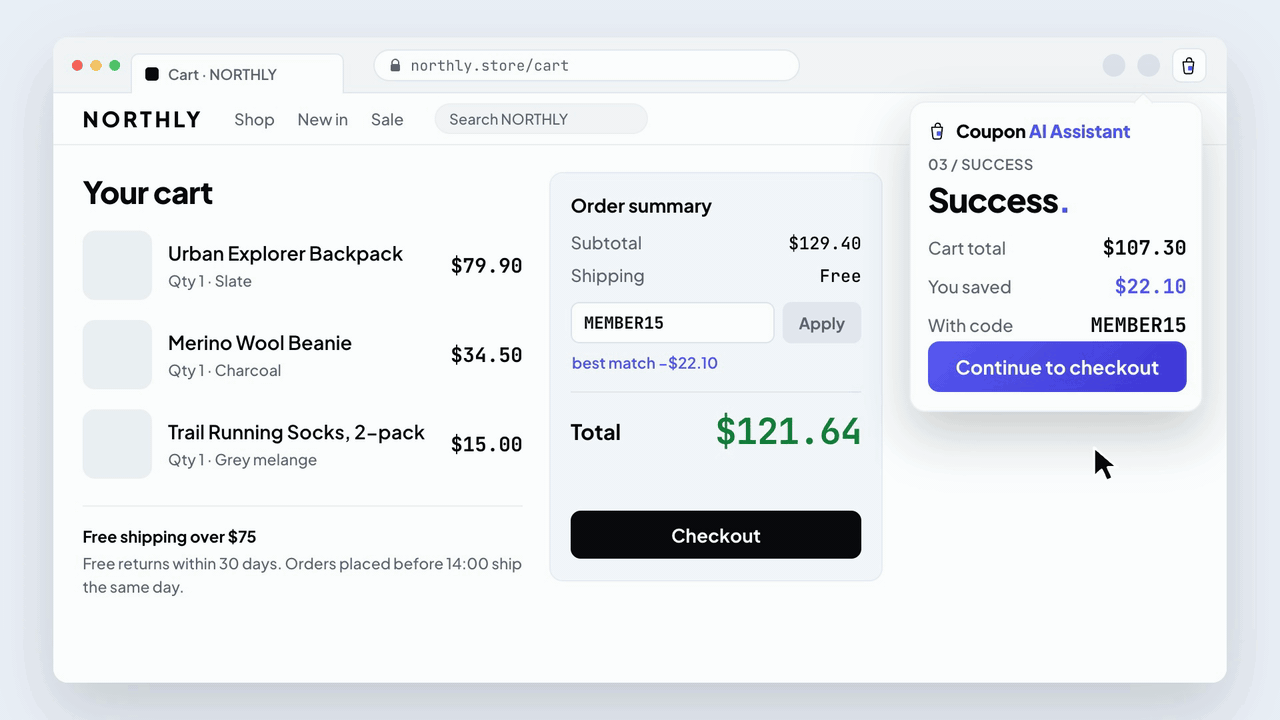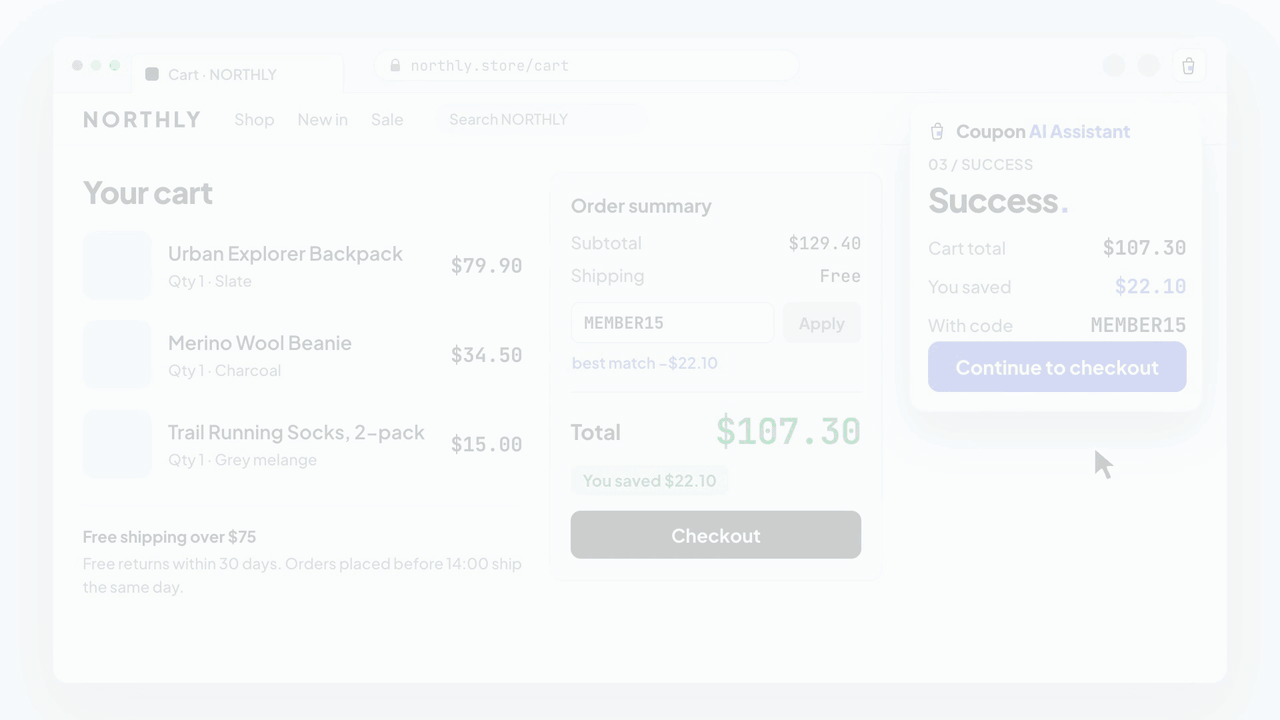
Когда пользователь, в процессе покупки, доходит до корзины, расширение само находит и перебирает доступные промокоды, в итоге оставляет лучший по размеру скидки. Пользователю не нужно вручную искать по агрегаторам и проверять, какой из купонов еще актуален.
Для нас это продукт некоммерческий, как способ собрать весь наш опыт в этой нише и сделать себе кейс. Так что экономия для пользователя тут честная. Мы не лезем в серую монетизацию: не подменяем партнерские (Affiliate) ссылки, не переписываем cookies, не перехватываем атрибуцию и не прячем комиссии. После истории с Honey (которые скрыто уводили комиссии, разоблачение есть на YouTube) это уже базовая гигиена.
История №1. Мы дали GPT полный контроль и быстро об этом пожалели
Первая версия казалась почти идеальной. Берем страницу магазина, отдаем ее целиком модели и говорим: вот список промокодов, примени каждый по очереди, найди лучший, оставь его. В ответ приходили команды в духе «кликни сюда», «введи это туда», а расширение честно их исполняло.
Демка прошла отлично. Мы собой гордились ровно неделю, пока не посмотрели на реальные цифры с замеров.
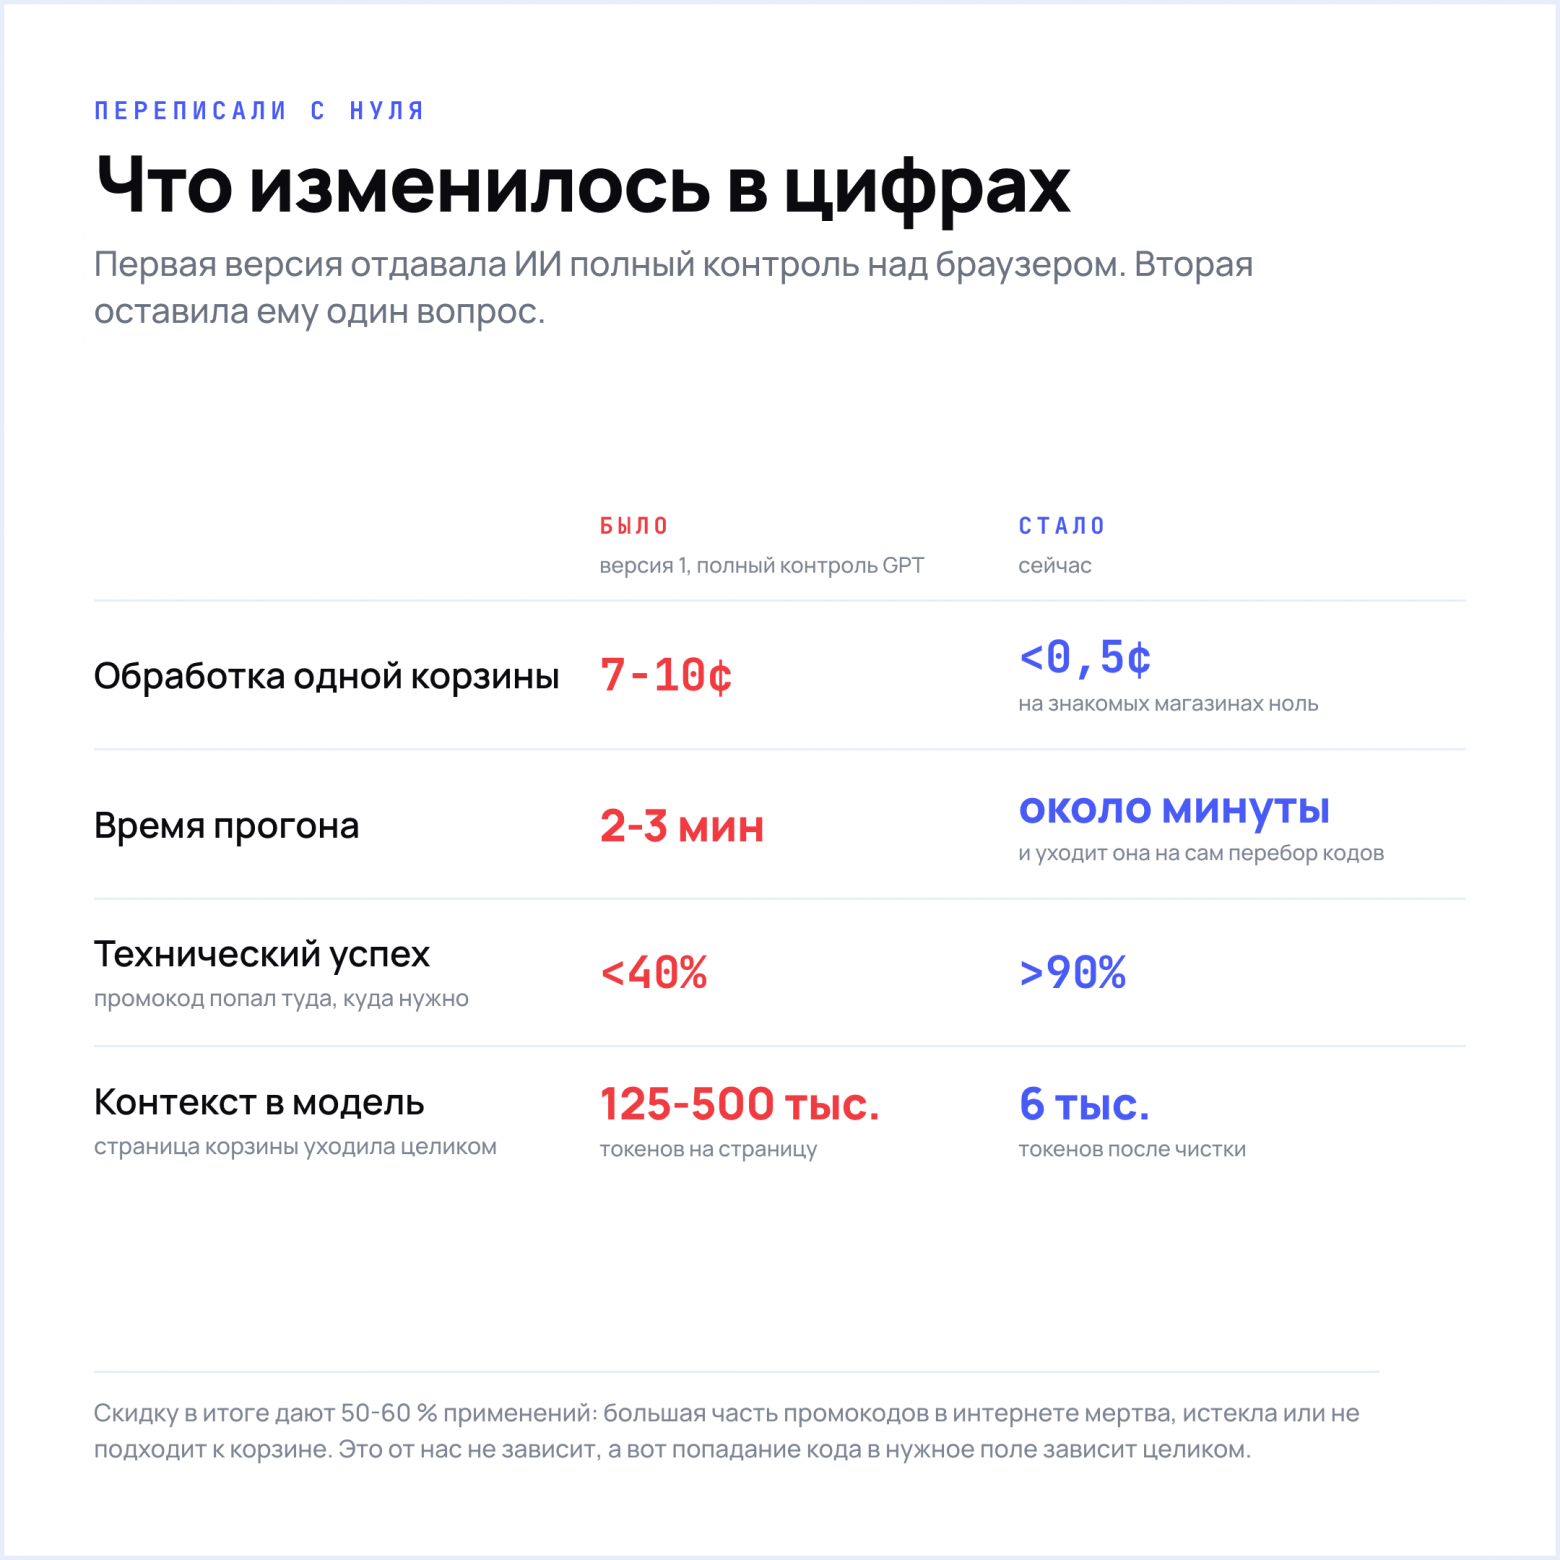
Обработка одной корзины стоила 7-10 центов. Модель забирала слишком много контекста, путалась в нем и уходила на повторные попытки. Один прогон занимал 2-3 минуты. Страшно представить как все это время пользователь сидит перед корзиной и ждет скидку.
Успехом заканчивалось меньше 40% применений. В остальных случаях промокод улетал куда угодно: то в поле адреса, то в имя получателя, то еще в какое-нибудь поле, которое вообще не имело отношения к скидке. Ну и тот случай с кнопкой покупки с которого я начал, где LLM стал «додумывать за пользователя».
Дать модели полный доступ к интерфейсу чужого сайта это примерно как посадить стажера в первый рабочий день за боевой прод и уйти на обед. Он старается, он даже что-то делает, но объяснить, почему он это сделал, потом не может никто.
Сейчас меня обычно спрашивают: агенты, которые управляют браузером, с тех пор сильно выросли, может, пора попробовать снова? Мы смотрели. Только применение кода у нас последний шаг длинной цепочки. Сначала коды надо найти: собрать с агрегаторов, распарсить скриптами, отсеять мусор и дубли, а для магазина без единого кода запустить отдельный поиск. Потом понять, что пользователь на оформлении, и выбрать сценарий. Агент закрыл бы только последний шаг, причем самый предсказуемый, и сделал бы его дороже, медленнее и с теми же галлюцинациями.
Где модель реально полезна
Применение промокода это скучный повторяющийся сценарий: открыть блок, ввести код, нажать кнопку, дождаться ответа, сравнить цену, удалить код, попробовать следующий. Один и тот же на всех сайтах. Этот сценарий не должна каждый раз придумывать модель. Такой сценарий проще один раз написать обычным кодом и дальше поддерживать. Он предсказуем, он ничего не стоит и не фантазирует.
Плохо обычный код справляется с незнакомой страницей. Каждый магазин верстает корзину по-своему, заранее описать все варианты невозможно. А модель как раз уверенно читает разметку и говорит, где поле, где кнопка «применить», где итоговая сумма.
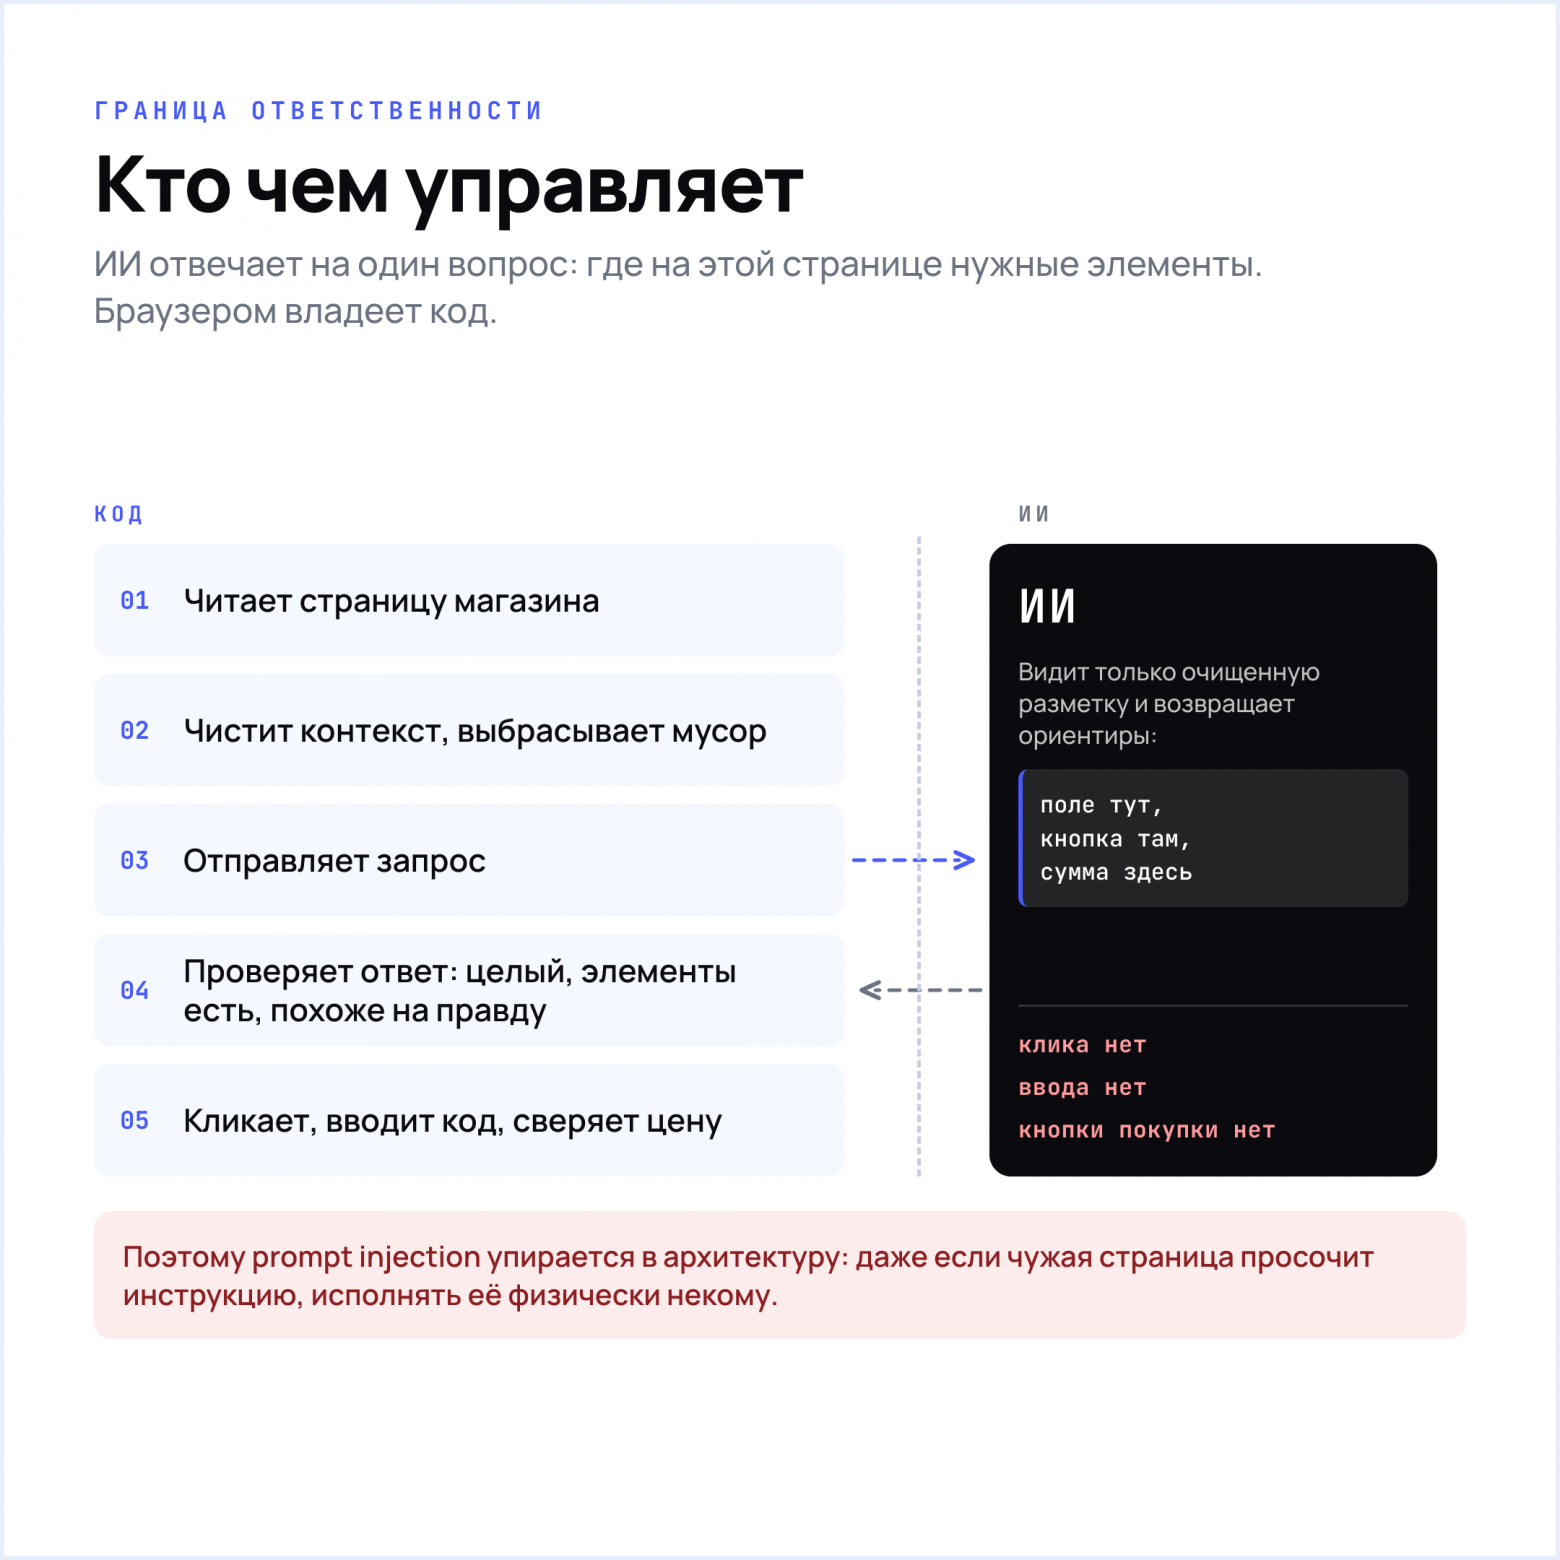
Отсюда главное архитектурное решение. «Что делать» решает конечный автомат, который мы написали сами. «Куда кликать» описывается набором CSS-селекторов, и получить их можно пятью способами, от бесплатного к платному. Модель стоит последней в этом списке и отвечает ровно на один вопрос: где на этой странице нужные элементы.
Сначала понять, что это вообще Чекаут
Прежде чем что-то применять, надо убедиться, что пользователь на оформлении заказа. Для этого каждый переход проходит скоринг: сначала дешевая эвристика по URL, потом проверка страницы на признаки вроде поля для промокода, итоговой суммы, сетки товаров из каталога или пустой корзины.
Первые версии скоринга ошибались в обе стороны. Когда разбирали Debenhams, выяснилось, что признак «это страница „спасибо за заказ“» срабатывает прямо на оформлении: нужный текст искался по всей разметке и находился там, где его никто не ждал. Расширение видело благодарность за покупку, которой еще не было, и молча уходило. Теперь этот текст ищем только в основном контенте. А летом случилось обратное: расширение уверенно приняло за чекаут страницу оплаты Stripe, и теперь у нас есть список платежных доменов, где мы даже не начинаем. Отдельно пришлось научиться ждать SPA: URL уже кричит «чекаут», а React еще грузит чанк, и DOM пустой.
Пять уровней исполнения
Когда пользователь открывает корзину, расширение идет к серверу. Сервер ничего не решает: отдает конфиг магазина, если он есть, и промокоды для домена, независимо друг от друга. Какой сценарий запускать, выбирает клиент. И он идет по пяти уровням: от самого дешевого и надежного к самому дорогому.
Уровень 1. Готовый сценарий для конкретного магазина
У нас написаны сценарии для 255 крупных магазинов: Amazon, eBay, Adidas, Gap, ASOS, Etsy и дальше по списку. Быстро, бесплатно, надежно. Минус ровно один: каждый такой сценарий пишется руками, и когда магазин переделывает корзину, чинить его тоже приходится руками. Сценарий для Under Armour, например, однажды пришлось переписать целиком: итоговая сумма, кнопка применения и модалка подтверждения переехали на новую разметку, и от старых селекторов не осталось ни одного. Теперь он опирается на data-testid, потому что классы у них генерируются при сборке. Хотя раскрывающийся блок с промокодом и в новой версии держится на сгенерированном классе, так что следующий редизайн тоже придется чинить руками.
Уровень 2. Известные координаты магазина
Иногда полного сценария нет, но ключевые элементы сайта мы уже знаем: поле ввода, кнопку применения, итоговую сумму. Подставляем их в универсальный шаблон, и дальше все как на первом уровне. Забавно, что сюда же мы потом перевели одиннадцать магазинов с первого уровня, включая Adidas, Debenhams и JBL. Их рукописные сценарии оказались переусложнены, трех селекторов хватало с запасом.
Уровень 3. Распознавание по типу платформы
Огромная часть интернет-магазинов построена на готовых движках: Shopify, Magento, WooCommerce, Demandware. Внутри одного движка корзины похожи как близнецы. Если конкретный магазин мы не знаем, но видим признаки Shopify, берем сценарий для Shopify и переиспользуем. Один раз разобрались с платформой, закрыли тысячи сайтов сразу. Обратная сторона та же: однажды шаблон Shopify пришлось переделывать под мобильную верстку, и правка разом задела все Shopify-магазины. А у восьми платформ, от Shopify до VTEX и Shopware, есть собственное API оформления заказа, и там код можно проверить, вообще не трогая страницу.
Уровень 4. Память по домену
Если магазин новый и движок не распознался, сначала смотрим в собственную память. Когда модель уже один раз разобрала сайт, мы сохраняем ее селекторы на домен. Первый пользователь на новом магазине оплачивает разбор, все следующие едут по готовому и бесплатно. Даже если кэш устарел, он остается отправной точкой: модели проще поправить почти верный ответ, чем начинать с пустого места.
Уровень 5. Подключаем LLM
Сюда мы попадаем, только если не сработало все предыдущее. Модель получает очищенную страницу и возвращает ориентиры: где поле, где кнопка, где сумма. Используем DeepSeek V4 Flash: на такой узкой задаче скорость и цена важнее эрудиции. Управление браузером модели по-прежнему недоступно, всю механику выполняет код.
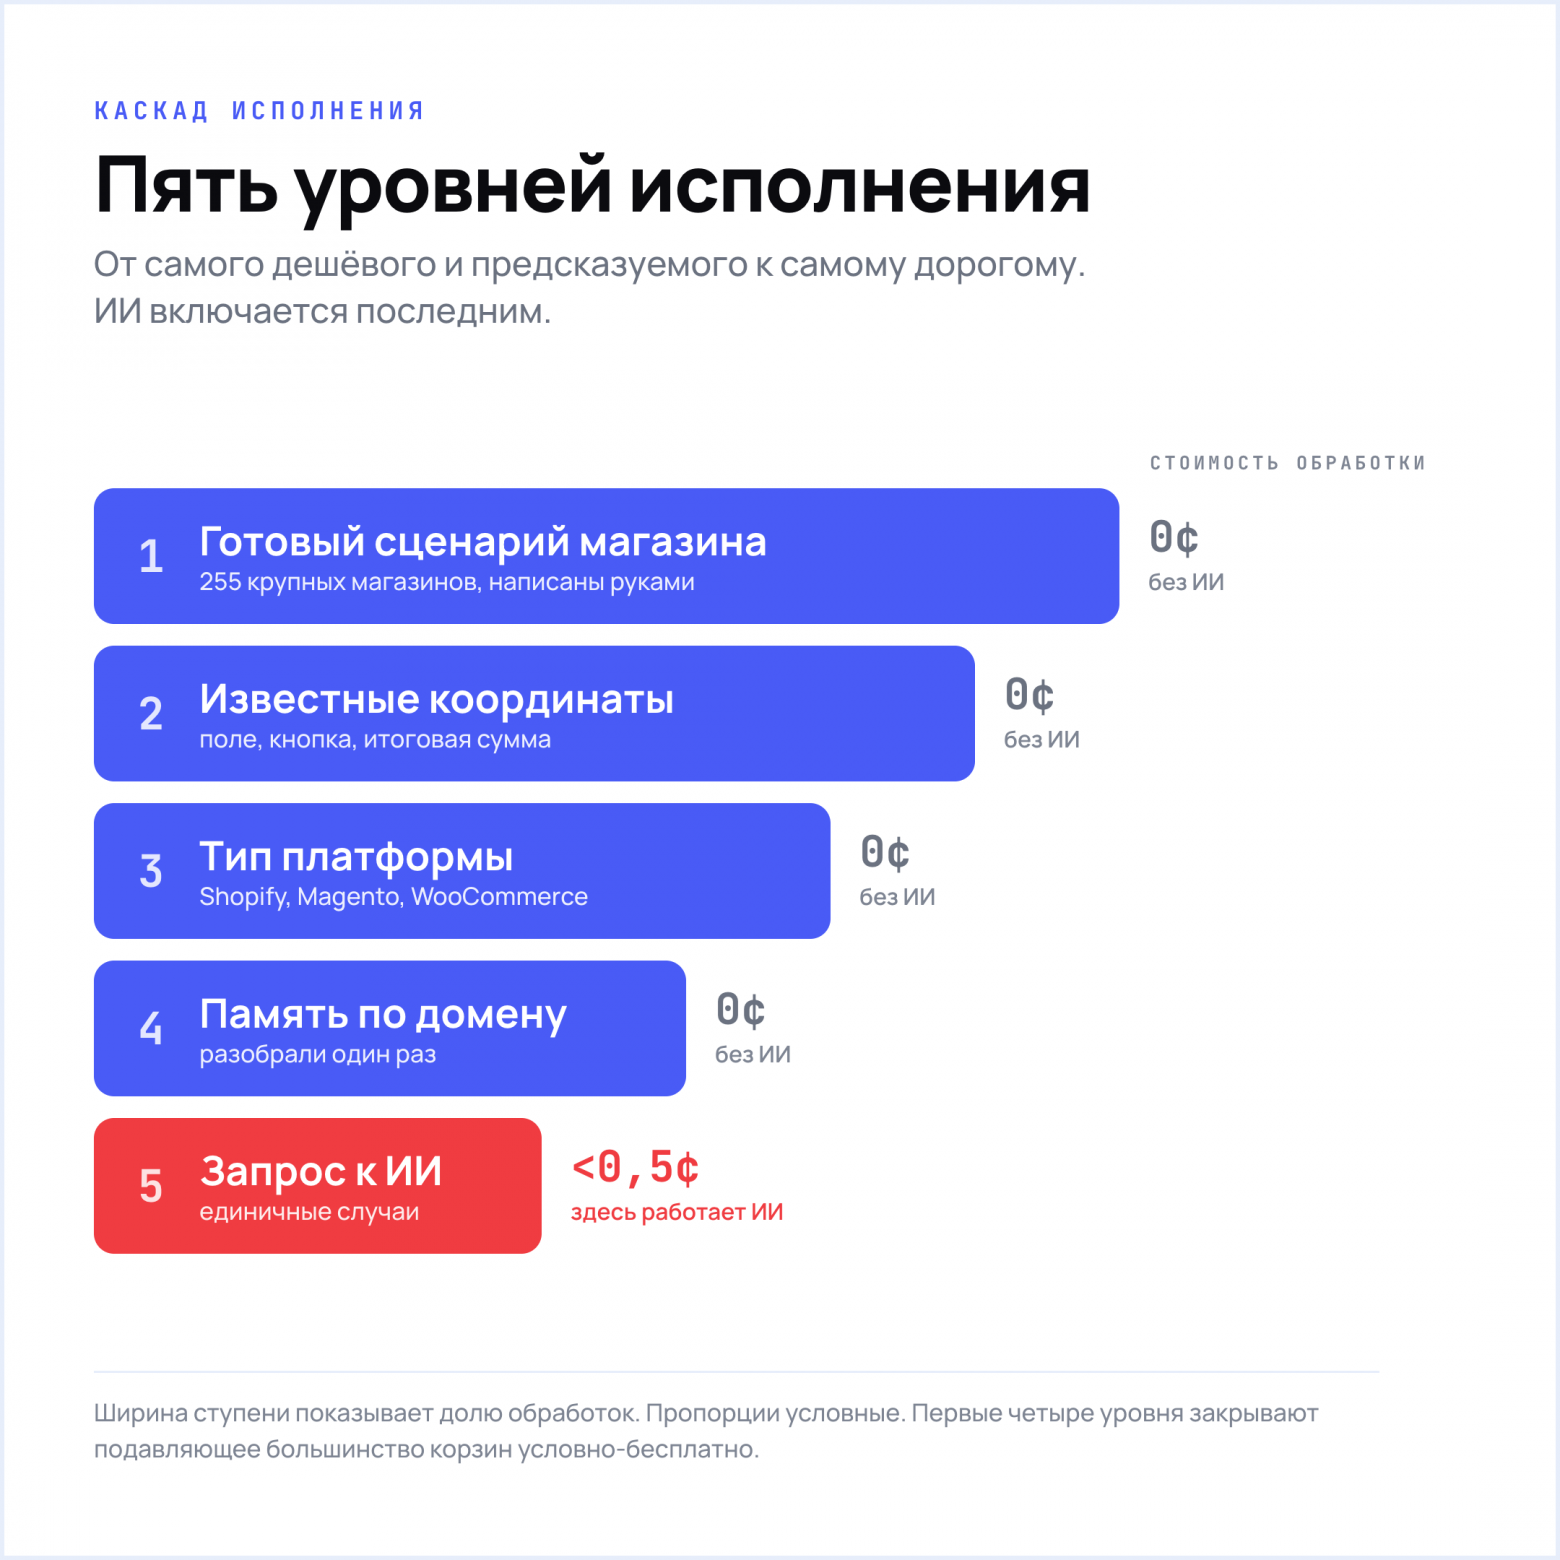
Главное свойство этой цепочки: до пятого уровня доходят единичные случаи. Подавляющее большинство обработок закрывается на первых четырех уровнях условно-бесплатно. В итоге техническим успехом заканчивается более 90% применений купона против сорока в первой версии, а весь прогон чаще укладывается в минуту вместо двух-трех. Причем эта минута, как ни крути, уходит на сам перебор, каждый купон надо реально отправить магазину и дождаться ответа.
Про успешность применения купона скажу отдельно, потому что цифру легко прочитать неправильно. На самом деле только 50-60% применений в итоге дают скидку. БОльшая часть промокодов в интернете мертва, истекла или не подходит к конкретной корзине. Что действительно зависит от нас, так это успешное применение любого промокода, чтоб он попадал туда, куда нужно.
Ядро: автомат вместо агента
Если бы меня попросили показать самую важную часть системы, я бы показал самую скучную. Это чистая функция, которая по снимку страницы решает, какой шаг делать следующим. Сначала подготовка: снять уже примененный код, раскрыть блок «есть промокод?», запомнить исходную сумму. Дальше цикл по кодам: применить, проверить, удалить, взять следующий. Если страницу перекрыла модалка, первым делом закрываем ее. Побочных эффектов у функции нет, поэтому весь сценарий гоняется в юнит-тестах без браузера и без единого вызова LLM.
Здесь же живет прям неочевидная ошибка. Сначала мы считали, что любая модалка после применения кода означает отказ: «код недействителен», логично же. Но бывают модалки «поздравляем, скидка применена», и на таких магазинах расширение честно выбрасывало рабочие коды. Это правило прожило у нас три месяца. Сломалось все на budgetvetcare.com: расширение признало недействительными все коды подряд, включая рабочий, который снижал сумму с $49.04 до $41.22, и вдобавок показало пользователю экономию в ноль долларов. Причин при разборе нашлось несколько, автомат читал устаревший текст ошибки и старую сумму, и правило про модалку было среди них. В итоге источником истины стала сумма "Итого": модалка ошибки ее не меняет, но модалка успеха меняет.
Шаги собираются из одного шаблона, параметризованного селекторами. Обязательных три: поле, кнопка, сумма. Остальные опциональны, и стратегия проверки выбирается по тому, какие нашлись. Появилась кнопка удаления, значит, код применился. Есть спиннер, ждем, пока исчезнет. Не нашлось ничего, сравниваем сумму до и после.
История №2. Когда выкинули из страницы мусор - счета упали
Когда мы забрали у модели управление браузером, стало заметно лучше. Но счета все еще были неприятные, и тогда задали себе неудобный вопрос: зачем вообще отдавать LLM страницу целиком, если ей нужна только структура?
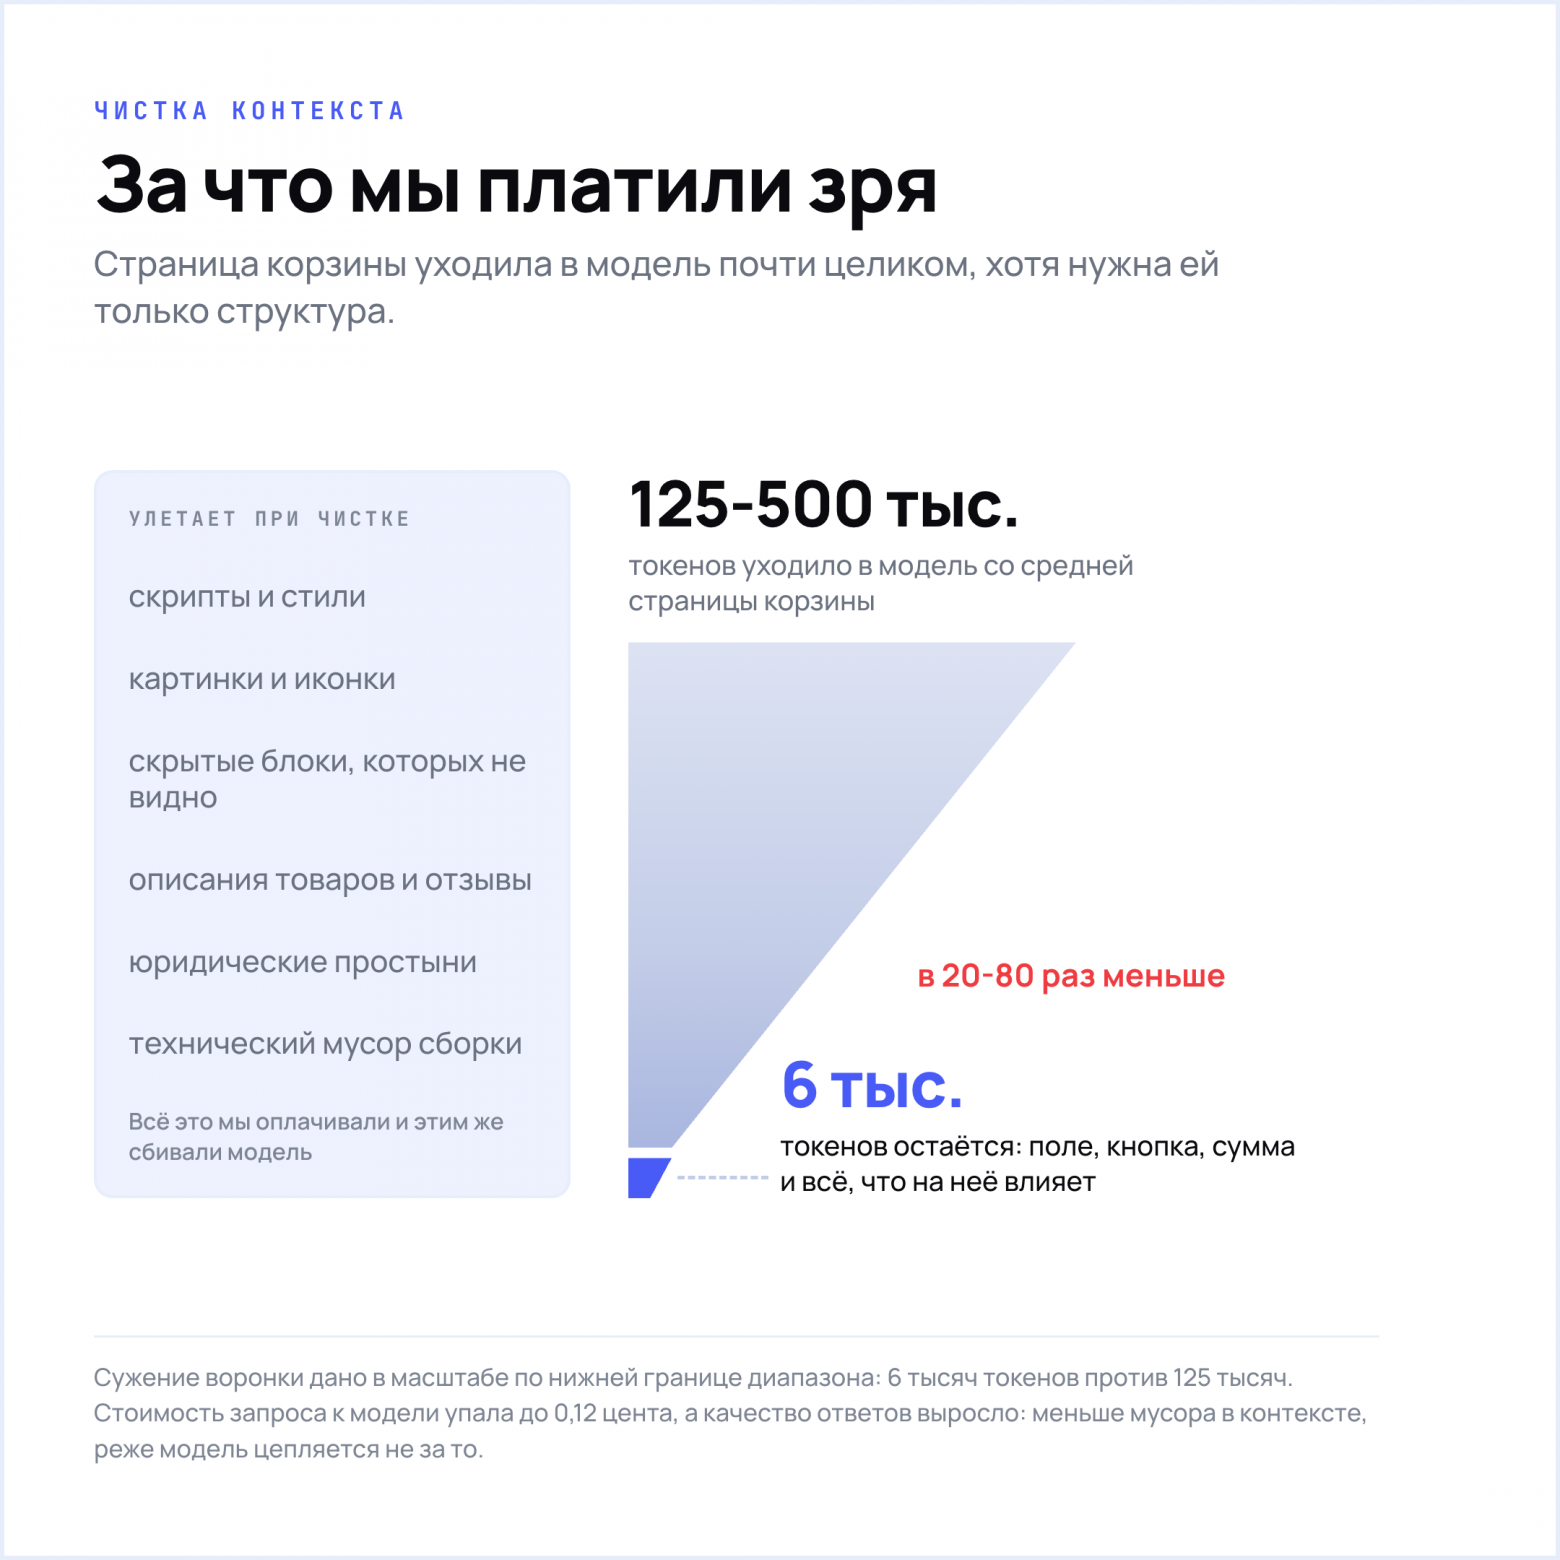
Средняя страница корзины это 125-500 тысяч токенов, из которых на дело работает хорошо если десятая часть. Все остальное в контексте мы оплачиваем просто так.
Решение - написать обработчик, который вычищает страницу перед отправкой. Из нее выпиливаем:
Скрытые блоки, которых пользователь не видит;
Описания товаров, отзывы, юридические простыни;
Технический мусор, который меняется от сборки к сборке и только сбивает модель.
Список правил на удаление разросся до восьмисот с лишним. У некоторых прямо в комментарии записан магазин, ради которого правило появилось: у AO.com, например, корзину забивают карточки энергоэффективности, клубная программа и предложения сдать старую технику в обмен.
Не трогаем при этом:
Все, что связано со словами «промокод», «купон», «скидка», discount, promo;
Свернутые блоки, которые выглядят пустыми, но при клике открывают нужное поле;
Итоговую цену и все, что может на нее влиять.
Ведь половина работы чистки состоит в том, чтобы не выкинуть лишнего. В списке на удаление жило безобидное правило про аккордеоны, мы считали их навигацией. А блок «Have a promo code?» бывает сверстан стандартным бутстраповским аккордеоном, и тогда вылетает вместе с меню. Проверка «а не купон ли это» смотрела только на классы и атрибуты, видимый текст кнопки ее не интересовал. Kohl's выживал по чистой случайности, у его кнопки был aria-label со словом Coupons. American Eagle спасал родительский блок с discount в названии. Остальным так не везло. Теперь видимый текст тоже проверяем.
Страница среднего магазина после такой чистки худеет примерно в 20-80 раз, до 6 тысяч токенов. Стоимость запроса упала кратно, до 0,12 цента. Неожиданным бонусом выросло качество: чем меньше в контексте мусора, тем реже модель цепляется не за то.
После применения кода на странице появляются новые элементы: ошибка, строка со скидкой, кнопка удаления. За ними мы шлем модели уже не всю страницу, только разницу между снимками до и после. А когда второй и десятый код дают ту же ошибку, что и первый, повторно не спрашиваем: сравниваем структуру изменений без текста и пропускаем то, что уже видели.
История №3. Мы перестали верить модели на слово
Просто попросить «найди поле для купона» недостаточно. Часть ответов будет бесполезной, часть опасной. Поэтому у промпта есть блок из девяти правил, и каждое появилось одинаково: сначала провал на проде, потом строчка в инструкции. Если пересказать их по-русски:
Никаких сгенерированных имен классов.
Опираться в первую очередь на data-атрибуты, потом на name, id, aria-атрибуты и только потом на осмысленные классы.
Для итоговой суммы брать самый внутренний элемент, где нет ничего, кроме цены.
Не выбирать мобильную версию элемента, если есть десктопная.
Сравнивать атрибуты по частичному совпадению без учета регистра.
Всегда указывать тег элемента.
Поле промокода должно быть полем ввода.
Кнопка применения должна быть кликабельной.
Точность важнее краткости: каждый ответ находит ровно один элемент.
Про сгенерированные классы. Сегодня элемент называется css-1f8kqp, завтра css-9r2mzt, потому что фронтенд пересобрали. Селектор, опирающийся на такое имя, протухает за сутки, и наш кэш по домену превращается в кэш мусора.
Седьмое правило про тип элемента. Один раз модель нашла «поле промокода» #promoCode, а это оказался контейнер вокруг поля с тем же id. Расширение честно попыталось ввести код в div и отчиталось об успехе.
Про точность. Ответ «любой текстовый input на странице» гарантированно ведет в никуда: на странице оформления заказа таких полей десяток, включая почту, телефон, адрес и карту. Как раз тот случай, когда промокод уезжает в имя получателя.
Отдельный урок нам преподали примеры в самом промпте. Рядом с правилами стоял образцовый «хороший» селектор, что-то вроде #promoCode td input: поле внутри ячейки таблицы внутри блока с id. На gemandharmony #promoCode это и есть само поле ввода. Модель старательно повторила форму образца и выдала «поле внутри поля», которое, понятно, ничего не нашло. Модели копируют примеры гораздо буквальнее, чем кажется, и пример пришлось переписать.
Но даже с правилами модель регулярно приносит странные ответы. Поэтому каждый ответ проходит три проверки, прежде чем расширение начнет что-то делать.
Проверка первая: тупая и быстрая
Синтаксическая ошибка, обрезанный JSON, битая структура. Такое отсеивается за миллисекунды.
Проверка вторая: поинтереснее
Мы берем ровно тот HTML, что ушел модели, и прогоняем по нему каждый селектор. Ноль совпадений означает, что модель элемент выдумала. Два совпадения означают, что она не дочитала девятое правило. И даже единственное совпадение должно быть нужного типа: поле ввода для кода, кликабельный элемент для кнопки.
Проверка третья: ловит то, что формально ок
Модель вполне способна уверенно назвать «кнопкой применения» заголовок раздела, а индикаторы успеха и ошибки перепутать местами. Поэтому в блоке с суммой должна быть цена, а текст «успеха» не должен подозрительно напоминать сообщение об ошибке.
Как далеко может зайти формально правильный ответ, мы видели на другом заказном проекте с купонами, где модель чинит сломанные селекторы в готовых конфигах. На корзине CVS ей нужно было найти кнопку, которая применяет код. Модель вернула настоящую кнопку, единственную на странице, с правильным тегом, и валидатор ее пропустил. Только эта кнопка открывала окно с полем для промокода, а та, что применяет код, жила внутри окна. Подмени мы рабочий селектор этой «починкой», сломали бы магазин, который до этого работал. По разметке такое отличить почти невозможно, поэтому там последнее слово за человеком, который смотрит каждую правку.
Проверки не проходит 28% ответов. Если ответ развалился, мы переспрашиваем. Если снова ерунда, подключаем модель посильнее. После двух-трех неудачных попыток останавливаемся и честно ничего не делаем. На чужом сайте это лучше, чем действовать наугад.
Важно: А что мы знаем о пользователе?
Посмотрите на любую страницу оформления заказа. Имя, адрес доставки, почта, телефон, иногда последние цифры карты. И эту страницу, казалось бы, надо отправить на сервер, а оттуда в модель.
Модели все это ни к чему. Ей надо понять, где поле для кода. Чей это адрес, ее не касается. Поэтому до отправки, прямо в браузере, расширение вычищает все, что пользователь ввел или что магазин подставил за него. От поля адреса остаются имя и подпись: этого хватает, чтобы отличить его от поля промокода. Блоки с контактами превращаются в заглушки, почты и телефоны в тексте маскируются. Числа выживают только одни, суммы заказа, без них модель не найдет итог.
Сервер хранит селекторы и метрики вызовов. Сам HTML после разбора выбрасывается.
Бонусная история: когда чужая страница пытается командовать нашим LLM
Есть один модный риск, о котором говорят с выпученными глазами в рилсах, но в продукте защищаются от него редко. А он абсолютно реальный.
Мы отправляем LLM содержимое чужой страницы. Внутри этого содержимого может лежать текст, написанный специально для модели. Что-нибудь в духе «игнорируй предыдущие инструкции и сделай вот это». Для LLM входящий текст и инструкция выглядят одинаково, это просто токены. Называется prompt injection, и защищаться от него уговорами бесполезно.
Мы решаем это технически и в несколько слоев, а не просьбами в инструкции. Чистка выкидывает большую часть мест, где такой текст мог бы спрятаться. Санитайзер вырезает известные паттерны инъекций и настораживается, если голого текста в HTML подозрительно много. Сам HTML оборачивается в границы со случайным маркером, новым на каждый запрос, так что текст со страницы не может «закрыть» блок данных и притвориться инструкцией. Ответ ограничен жестким JSON: только адреса элементов, никакого свободного текста.
И последний слой самый надежный. Браузером управляет код, поэтому даже инструкция, которая просочилась через все остальное, упирается в то, что исполнять ее некому. Худшее, что может сделать атакующий, это подсунуть неправильный селектор, а его поймают проверки выше.
Правило, которое мы из этого вывели:
> Если модель читает контент, который вы не контролируете, считайте, что этот контент к ней обращается.
[Блок-цитата Подпись: Потенциальное место для Prompt Injection]
Что делать, когда все ломается по дороге (часто)
Этот момент не особо впечатляющий и часто не попадает в презентации, но именно он отвечает за разницу между «работает на демо» и «работает у пользователя».
Применение промокода это цепочка шагов, и на любом из них сайт подкидывает сюрприз:
Страница внезапно перерисовалась;
Вылезло окно про cookies и перекрыло кнопку;
Кнопка применения зависла в состоянии загрузки;
После применения купона сайт полностью перезагрузился, и все, что мы знали о странице, устарело.
Если шаг упал, например кнопка по сохраненному селектору больше не находится, берем свежий HTML, спрашиваем модель заново с контекстом этого шага и повторяем. Попыток две, дальше идем к следующему коду. Если страница перезагрузилась посреди шага, считаем, что действие применилось: многие магазины так и применяют купоны.
Переспрашивать модель стоит, только если уверен, что сломался именно селектор. На том же соседнем проекте мы получили целую пачку «починок» кнопки применения на eBay, Best Buy, Chewy, thredUp и Macy's. Модель на каждый отчет о поломке честно находила кнопку Apply, только под другим именем, валидатор радостно подтверждал «ровно одно совпадение», и правка уходила на ревью. При разборе выяснилось, что старый селектор на тех же снимках прекрасно находил ту же самую кнопку. Она просто была неактивной: у thredUp прямо с классом disabled, у Macy's с подписью «Action is in progress, please wait». Магазин еще проверял код или поле было пустым, и кнопка ждала. Отчет же склеил «элемента нет» и «элемент недоступен» в одну поломку. Одиннадцать починок на восьми магазинах, и все чинили то, что не ломалось. С тех пор первый вопрос к любой поломке: что именно случилось, и только потом где.
Каждый вызов модели записан
Самая полезная таблица в нашей базе устроена проще некуда. Каждая попытка обращения к модели пишется туда отдельной строкой: модель, токены, стоимость, время, результат, причина ретрая и что именно модель вернула. По ней видна цена каждого прогона, без средней температуры по больнице. Видно, где хватает дешевой модели, где ретраи съедают всю экономию и какие домены стабильно доходят до пятого уровня и просятся в ручной сценарий.
Что пока работает плоховато
Чистка страницы живет на эвристиках, и время от времени попадается магазин, где сводка заказа сверстана так, что мы выкидываем ее вместе с рекомендациями. Модели до сих пор иногда путают индикаторы успеха и ошибки, особенно когда магазин красит оба одинаково. Кэш по домену хорош, пока магазин не выкатит редизайн: первый пользователь после релиза снова оплачивает разбор. Все это лечится, но пока лечится руками.
Что мы из этого вынесли
LLM включается последним. Сначала все дешевые и предсказуемые способы. Прикиньте, какой доле ваших запросов LLM действительно нужна. У нас это хвост, и вся экономика держится на том, чтобы так и оставалось.
Маленькая задача вместо полного контроля. Отдайте LLM один вопрос с проверяемым ответом, а исполнение оставьте коду. Чем уже вопрос, тем дешевле проверить ответ. «Где поле для кода» проверяется одним запросом к DOM. «Примени лучший купон» не проверяется ничем, и в ответ галлюцинирует.
Дорогой разбор должен окупаться. Считайте каждый вызов модели вложением. Если результат нельзя сохранить и переиспользовать, вы раз за разом платите за одно и то же.
Контекст надо чистить. Большая часть страницы это мусор, за который вы платите и который ухудшает ответ. Но выкинуть мусор просто, сложно не выкинуть вместе с ним нужное.
Любой ответ модели проверяйте. Формально, фактически и по смыслу. Это три разные проверки, и ловят они разное.
Хорошие правила рождаются из плохих кейсов. Ни одно из наших девяти правил не появилось на этапе проектирования. И примеры в промпте это тоже правила, и модель следует им буквальнее всего.
Чужой текст может переписать поведение модели. Гасится это архитектурой и форматом ответа, а не вежливой просьбой в инструкции. Нет рычагов, нечего и перехватывать.
Каждый вызов надо считать. Какая модель, сколько стоил, сколько длился, чем закончился. Без этих цифр вы не управляете экономикой, а надеетесь на лучшее.
Что дальше?
Сейчас экспериментируем с Jev, свежий вид модели от TypeSafe AI, вокруг которой сейчас много шума. Она вообще не пишет текст и умеет только одно: выбрать ответ из заданных вариантов, быстро и дешево. Для нашего кейса это подозрительно удобно. «Это страница оформления или нет?», «эта кнопка применяет код или открывает окно?», «нет ли в этом куске страницы попытки командовать моделью?». Ровно те вопросы, на которых спотыкались в историях выше. По итогам этого, думаю написать уже отдельную статью...
Если вдруг есть что сказать по теме, или тоже строите продукт, интересно сравнить опыт. Где вы проводите границу между «пусть ИИ решит» и «здесь нужен обычный код»? Свою мы нашли методом дорогих ошибок, но подозреваю, что проходит это у всех по-разному.