Почему я выбираю Rust, даже когда код пишет ИИ
- суббота, 7 ноября 2026 г. в 00:00:15
Хабр, привет, меня зовут Никита, я Rust-разработчик.
Недавно прочитал на Хабре статью «Go сделали скучным — и после нейросетей это выстрелило». В ней намеренная простота Go подаётся как удачное решение, которое пригодилось ещё и при работе с нейросетями. И я задумался: некоторые возможности, которых в Go нет, мне как раз очень нравятся в Rust.
Я готов потратить время на изучение языка, если потом мне удобнее разбираться в коде и спокойнее его менять. С Rust у меня получилось именно так, хотя начиналось наше знакомство довольно болезненно.
Сейчас код за меня пишет агент. Я читаю его изменения, прошу переделать решения и потом возвращаюсь к этому коду. Поэтому мне всё ещё важно, на каком языке он написан.
Я пришёл в Rust из Python, на котором писал, пока учился на ML. Потом начались алгоритмы, и вокруг все писали циклы, внутри них условия, потом ещё циклы. А я к тому моменту уже знал другой способ: у меня друг JS-разработчик, и у них постоянно мелькали map, filter, reduce. Мне такой стиль понравился, и я тоже старался так писать на Python. Уже потом узнал, что это, оказывается, называется функциональным программированием.
Потом захотелось изучить язык, на котором можно было бы глубже разобраться с ФП и заодно найти работу. Учить что-то совсем в вакууме не хотелось, поэтому я смотрел и на языки, и на вакансии. В итоге выбирал между Scala и Rust. Сначала выбрал Scala: вакансий на неё мне попадалось намного больше, и они были ближе к тому, что я уже изучал. Data Engineering, Spark, Big Data. Я хоть и не курю, но на Scala «прикурил». Осилить у меня её на тот момент не получилось. Потом начал переходить на Rust. И тут меня почти везде останавливал borrow checker.
К тому моменту уже был ChatGPT, и я скармливал ему ошибки компилятора. В коде появлялись клоны, потом ещё клоны, и в итоге всё как-то работало. Почему работало и почему до этого не собиралось, я при этом не всегда понимал. Получается, я был вайбкодером ещё до самого появления термина.
Потом сел разбираться, как устроены владение и заимствования, чего от меня хочет borrow checker. Когда разобрался в логике его требований, работать с Rust стало понятнее, но не всегда приятнее.
Меня раздражает, когда отсутствие очередной возможности в Go некоторых языках подают как преимущество само по себе. Мне кажется, в таких разговорах иногда путают простоту с бедностью языковых средств.
Роб Пайк, один из авторов Go, в докладе 2015 года Simplicity is Complicated объясняет, что возможности усложняют язык и мешают читать код. Но там же он определяет простоту как искусство прятать сложность и приводит в пример сборщик мусора. Такая простота мне понятна: сложную работу за программиста делает рантайм.
От того, что в языке нет нужной возможности, сама задача никуда не девается. И не факт, что понравится решать её тем, что оставили. Разобраться в дополнительной конструкции языка может быть труднее на старте. Зато потом ею можно пользоваться в разных проектах, вместо того чтобы каждый раз писать и читать код, который её заменяет.
Кстати, в опросе команды Go за 2025 год 28% ответивших назвали отсутствие нужной возможности из другого языка одним из главных раздражителей. В открытых ответах обсуждали обработку ошибок, enum с данными, безопасность nil и многословность кода. Знакомый список.
Например, в посте об обработке ошибок команда Go показывает функцию, в которой из десяти строк реальную работу делают четыре, а остальные шесть выглядят как шум. При этом команда объясняет, почему решила сохранить существующий синтаксис. К ошибке часто нужно добавить контекст, на отдельную строку с if удобно ставить точку останова, а повторяющиеся проверки дописывает IDE, в том числе с помощью LLM.
Когда код пишет агент, можно сравнить, сколько токенов ему нужно на одну и ту же задачу на разных языках. Например, в эксперименте с MiniGit агент писал упрощённый Git на разных языках, а потом добавлял новые команды. У Opus 4.6 на Rust ушло примерно на 14% больше выходных токенов, чем на Go. В повторе с GPT-5.4 — на 11%. С Python разница была заметнее. Это одна небольшая задача, но какого-то космического разрыва между Go и Rust здесь не получилось.
А если уж эти токены бьют по кошельку, можно посмотреть и на китайские модели. Например, GLM-5.3 по отдельным кодовым бенчам вполне рядом с Opus 5. Миллион выходных токенов у GLM-5.3 стоит $4,4, у Opus 5 — $25. Сколько попыток понадобится на конкретном проекте — уже отдельный вопрос.
Лично меня такая разница между Go и Rust не убеждает отказываться от удобных мне возможностей языка. Код за меня пишет агент. А на ревью я его всё ещё читаю. И каждый раз в функции из 30 строк смотреть на 15 строк if err != nil { return err } — лично меня очень сильно раздражает.
В Rust мне понравилось сочетание знакомых идей и удобных дефолтов. Его делали с опорой на опыт других языков.
Переменные неизменяемые по умолчанию. Нужна изменяемость — явно пишешь mut.
Нормальные enum с данными и исчерпывающий match. Если перечислять варианты явно, без общей ветки для остальных, компилятор покажет, где нужно разобрать добавленный вариант.
Обычная ссылка в Rust не может быть null. Для значения, которого может не быть, есть Option<T>, и это сразу видно в типе.
Result и ?, чтобы соединять операции с ошибками без одинаковых if после каждого вызова.
Итераторы на любой вкус и цвет: от классических map, filter, reduce до всякой экзотики вроде map_while, rposition и try_rfold. Причём итераторы — zero-cost abstraction: компилятор часто сводит их в код обычного цикла. Что ещё нужно для счастья?
Ещё нравятся сообщения об ошибках: компилятор показывает, где проблема, объясняет, что не так, а часто ещё и предлагает исправление. Агенту можно скормить диагностику сразу в JSON через cargo check --message-format=json: с местами ошибок и подсказками. По этой теме даже сделали мем.
Правила safe Rust исключают use-after-free, двойное освобождение и гонки данных. Это предполагает корректный unsafe внутри библиотек; за него отвечают их авторы.
Отдельное спасибо за Cargo. Зависимости, сборка и тесты собраны в одном инструменте. Добавим сюда скорость выполнения и возможность получить готовый бинарник без всяких JVM и прочего.
Крутая кривая обучения у Rust всё-таки есть. Нужно разобраться с владением и заимствованиями, да и привычки из другого языка не всегда подходят. ИИшка эту кривую уже частично сглаживает.
С макросами тоже надо разбираться отдельно. ИИшка их, кстати, генерит неплохо, но потом ещё надо понять, что она там написала, и желательно протестировать.
Когда только учишься, borrow checker бьёт по делу и не даёт наворотить дичи с владением и заимствованиями. Но потом ты уже понимаешь, что делаешь, а он-то об этом не знает. Бывает, что код безопасен, но borrow checker не может это доказать. И приходится изворачиваться и искать обходные пути.
Кто-то ещё ругает синтаксис. Для меня он в целом норм, хотя сначала могут испугать лайфтаймы ('a, 'static) и турбофиш (::<T>). Ещё с непривычки можно искать return, а функция просто возвращает значение последнего выражения без ;. Явный return тоже есть, просто в конце функции его обычно не пишут.
Медленная компиляция. Rust может долго собираться, но над этим работают. На Хабре есть сравнение сборки одного проекта разными версиями Rust: один и тот же коммит hyperqueue на Rust 1.61 собирался с нуля за 26,1 секунды, а на 1.87 — за 14,7. Самому тоже можно подкрутить настройки.
Большое количество зависимостей. Подключаешь одну библиотеку, а она притаскивает ещё пару десятков, а то и сотню зависимостей. Тебе нужна одна функция, но собирать приходится всё это добро. Частично это решается фича-флагами. Но если автор бибы не предусмотрел возможность отключить ненужное, то всё, придётся тащить весь набор.
Ну и, конечно, async. Вот в Go обычную функцию можно запустить через go, а дальше её выполнением занимается встроенный рантайм. В Rust приходится отдельно разбираться с окраской функций и стыком синхронного и асинхронного кода. А если полезешь в устройство future, там ещё Pin и самоссылочные структуры. Понятно, что у этих решений есть причины, но разбираться со всем этим от этого не легче.
Когда я начал писать эту статью, мне хотелось открыть её красивой историей. Агент допускает ошибку, компилятор Rust плетью со всего размаха даёт ему по попе одному месту, мой будущий многомиллионный B2B AI SaaS спасён.
И вот, хотел я вспомнить такой случай ииии...
Пока писал статью, такая ошибка впервые за очень долгое время всё-таки случилась.
В одном из моих проектов агент объявил массив HTTP-заголовков через const. Видимо он, не заметил, что дальше по коду ссылка на этот массив использовалась в асинхронном вызове внутри tokio::join!.
Само объявление было допустимым. Но const задаёт значение, которое подставляется при использовании. При заимствовании этого массива создавалось временное значение. Внутри развёрнутого join! оно уничтожалось бы раньше, чем завершится future, которой нужны эти заголовки.
Тут Rust и дал агенту по попе одному месту: E0716: temporary value dropped while borrowed. Агент заменил const на static, и код собрался.
Borrow checker не знает, что код написал ИИ. Поэтому относится к нему так же плохо, как ко всем остальным.
Сейчас агент чаще спотыкается о линтеры и хуки. Поправил код, запустил проверки, поправил ещё раз. А иногда уже сам приходит ко мне: «Слышь, кожаный Дружище, тут баг в моём твоём коде, давай я исправлю».
Под свои требования приходится собирать скиллы и допиливать харнес. И всё равно иногда открываю код и заново объясняю агенту то, что уже написал в скилле.
Правда, агент тоже умеет делать выводы.
Когда Rust мешает завершить задачу, у агента есть два пути. Можно понять причину и исправить решение. А можно убрать препятствие. Иногда агент выбирает второй вариант.
Так появляются .clone() после каждого замечания borrow checker, unwrap() и expect() вместо обработки ошибки, Arc<Mutex<_>> вокруг непонятной модели владения. Программа собирается, но агент добился этого дополнительными копиями, возможной паникой или блокировкой. Гарантии языка соблюдены, а решение может совсем не подходить проекту.
С клонами я познакомился ещё при изучении Rust. Если для решения сделали отдельную копию данных, компилятор проверит владение этой копией. Он не станет выяснять, нужна ли нам она вообще и устраивают ли нас расходы времени и памяти на копирование.
С unwrap() похожая ситуация: программа явно допускает панику при ошибке. С точки зрения правил языка это допустимое поведение. Хотели ли мы завершать обработку именно так, компилятор решать не будет.
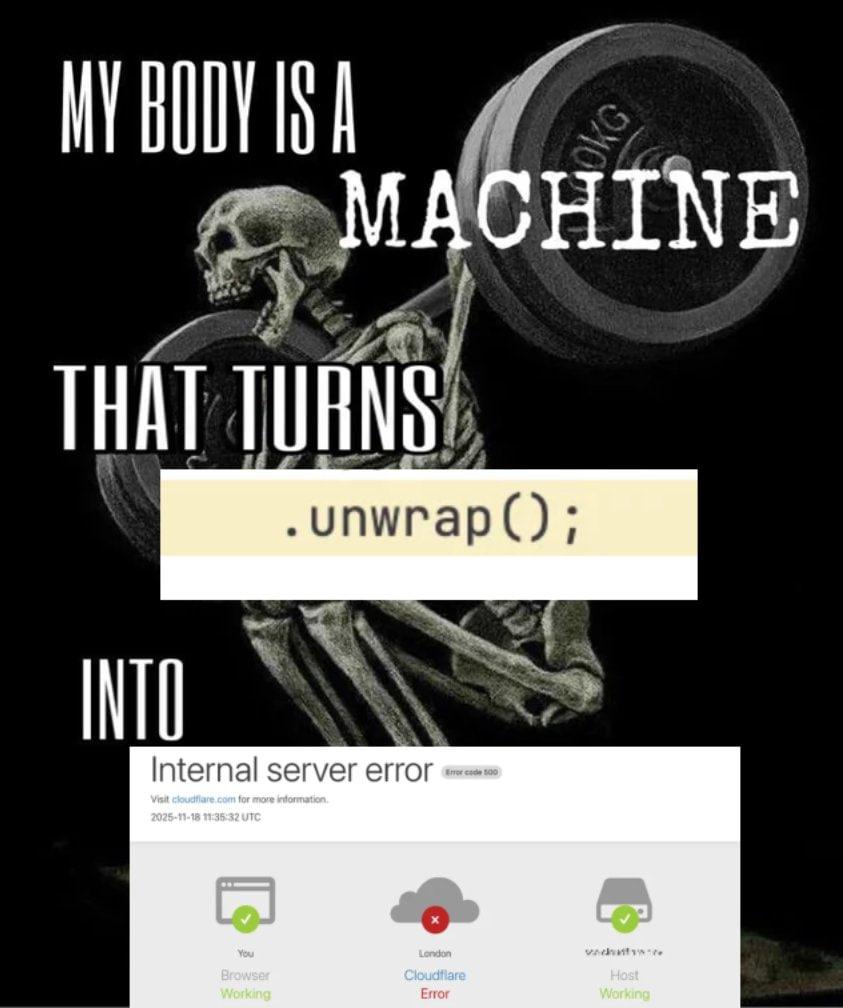
О последствиях unwrap() напоминает разбор сбоя Cloudflare 18 ноября 2025 года. Rust-прокси FL2 получил конфигурацию с числом признаков выше лимита. Вызов unwrap() на ошибке привёл к панике и ответам 5xx.
Главное, чего Rust не проверяет — логика. Точнее, её отсутствие. Иногда у агента, иногда у человека, который ставил задачу. Тут не хватает анекдота про идиотизм и вечный двигатель.
У всех этих инструментов есть нормальные применения. Но если агент берёт их только ради зелёного exit code, я хочу посмотреть, что именно он поменял.
Можно написать в AGENTS.md капсом «НИКОГДА НЕ ИСПОЛЬЗУЙ UNWRAP!!!». Агент прочитает, согласится и через двадцать минут напишет unwrap(). Сборка при этом пройдёт. Если в проекте такой вызов запрещён, правило можно закрепить линтами Clippy unwrap_used и expect_used. Тогда при согласованных настройках проверка обнаружит нарушение, даже если агент забыл текст инструкции.
Для завершения задачи остаются cargo clippy -- -D warnings и cargo test с согласованными настройками проекта. Но агент может изменить и сами типы, в которых мы записали требование, и конфигурацию проверок. Такие изменения тоже нужно читать: после ослабления требования прежняя ошибка может больше не обнаруживаться.
Поэтому правки линтов, новые #[allow] и ослабление существующих тестов требуют отдельного внимания на ревью. Удалённый тест не падает, и агент это прекрасно знает.
Rust может заставить дольше разбираться с первой версией программы, даже когда её пишет агент. Но раньше аргумент «да ладно, ещё железа накинем, и наш Python или PHP полетит» вполне мог сходиться по деньгам. Нанять разработчика, чтобы переписать сервис, или потратить на это своё время было дороже, чем добавить железа.
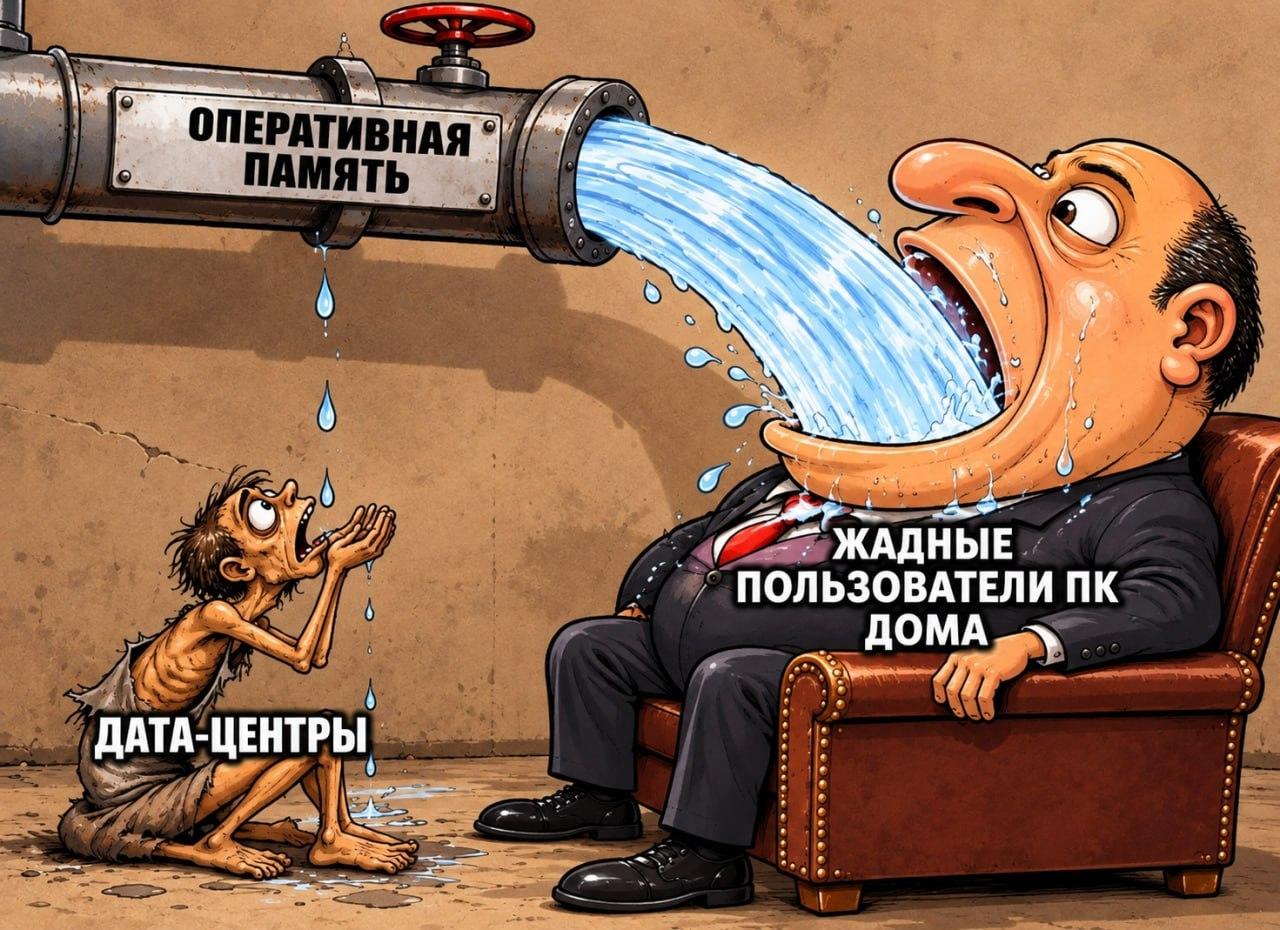
Раньше RIIR (Rewrite It In Rust) выглядел скорее как мем, а местами вообще как секта: «перепишите всё на Rust, и будет вам счастье».
Сейчас часть переписывания можно отдать агенту. Особенно если уже есть тесты, которыми можно проверить новую реализацию и поймать баги и регрессы.
За инфраструктуру при этом платишь каждый месяц. А если железо дорожает из-за дефицитов и прочих кризисов, аргумент про накидывание железа уже не такой сильный. Так что RIIR вполне может оказаться экономически оправданным решением. Тут уже стоит пересчитать.
И ради этого необязательно переписывать весь проект. Можно начать с одного прожорливого сервиса. Ему даже не обязательно отвечать быстрее: у Grab после переноса с Go на Rust задержка P99 осталась примерно той же, а CPU на ту же нагрузку понадобилось заметно меньше.
Только считать надо не одни токены. Новую реализацию ещё нужно проверить, внедрить, а потом поддерживать. Если на железе экономим копейки, даже дешёвое переписывание может не окупиться.
Правда, всё чаще слышу, что сгенерированный код вообще не обязательно сопровождать. Если модель через месяц напишет реализацию заново, зачем разбираться в старой? Проще выкинуть её и сказать клоду/чатГПТ: «Сделай как надо, а как не надо, не делай».
У старого кода есть ещё одна неприятная особенность: в нём могут остаться требования, которые из головы уже выветрились. Например, странная проверка когда-то закрыла редкий баг или обошла особенность чужого API. Заново сформулировать задачу — значит ещё и вспомнить всё это добро.
Если скрипт один раз переложил файлы, выдал правильный результат и отправился в мусорку, то и ладно. Но если у программы появились пользователи и данные, новую реализацию придётся проверять на совместимость.
Исходник можно выкинуть. Поведение, данные и пользователей — так-то тоже можно выкинуть, но есть нюанс.
В сервисе или библиотеке я рассчитываю возвращаться к коду много раз. Поэтому готов потратить больше времени на первую версию, если при следующих изменениях будет проще заметить, что я или агент что-то забыли. От агента я хочу получать код, который смогу понять и поддерживать дальше.
P.S. Многомиллионный B2B AI SaaS из пятой главы пока не написан. Поэтому оставляю ссылку на мой ТГ канал с IT-мемами: https://t.me/random_access_memes, спасибо за внимание.