Как я добавил лицо голосовому ИИ на Яндексе: Simli, Anam и проверка на iPhone
- воскресенье, 18 октября 2026 г. в 00:00:05
У моего голосового ИИ-администратора Айки уже были голос, сценарий разговора и работающая страница. Не было лица. Я хотел его добавить, сохранив Yandex Realtime: пусть новый сервис получает готовый звук и двигает под него губами.
Попробовал Simli и Anam. Лицо появилось, но вместе с ним пришлось разбираться с паузой перед ответом, запуском видео на iPhone и мобильным интернетом. А на втором персонаже, Еве, выяснилось, что убедительность портрета зависит не только от лица, но и от того, что у него за спиной.
Код писал Claude Code, часть вариантов внешности по моему ТЗ генерировал Codex. Решения, отбор и проверки на живом телефоне — мои.
В конце сентября Google показала Gemini Live с аватаром — на Хабре уже есть обзор этого подхода. У меня задача была другая: голосовой движок уже работает, переезжать с него ради лица я не хотел.
Айка разговаривает с посетителями сайта прямо в браузере. Браузер держит WebSocket с нашим сервером на FastAPI, сервер — сессию с Yandex Realtime. Это интерфейс «речь в речь»: мне не нужно отдельно собирать цепочку из распознавания, текстовой модели и синтеза.
Почему Яндекс, а не OpenAI, я разбирал в прошлой статье. Для этой истории важно одно: сервер отдаёт браузеру голос кусками PCM16 на 24 кГц, событиями pcm_chunk. PCM16 — несжатый звук, в котором каждый отсчёт занимает 16 бит. В обычном голосовом режиме браузер его проигрывает.
Задача: добавить лицо, которое двигает губами под этот звук, пока ответ ещё приходит.
Мне не нужен был новый конвейер из распознавания, языковой модели и синтеза. Нужна была только анимация лица. У обоих сервисов, которые я попробовал, есть такой режим: ты отдаёшь свой звук, сервис рисует под него лицо и возвращает аудио и видео по WebRTC — технологии передачи медиа в реальном времени.
Ответ по-прежнему придумывает и озвучивает Яндекс. Сервис аватара отвечает за картинку и её синхронизацию со звуком.
Первая техническая мелочь — частота. Яндекс в моей конфигурации отдаёт 24 кГц. Simli нужны 16 кГц, а для Anam я взял тот же формат, как в их JavaScript-примере. У Anam частота задаётся параметром: 16 кГц здесь — выбор нашей интеграции, а не универсальное ограничение сервиса.
Звук приходит чанками — кусками разной длины. Если на каждом куске начинать пересчёт с нуля, результат зависит от того, где прошла граница. Поэтому дробная позиция и последний сэмпл переносятся в следующий чанк. В этом примере AVATAR_RATE равен 16000:
const resampler = {
  pos: 0, prev: 0,
  reset() { this.pos = 0; this.prev = 0; },
  run(int16, inRate) {
    const n = int16.length;
    if (!n) return new Int16Array(0);
    const step = inRate / AVATAR_RATE;
    const out = new Int16Array(Math.ceil((n - this.pos) / step) + 1);
    let p = this.pos, k = 0;
    while (p < n - 1) {
      const i = Math.floor(p), f = p - i;
      const a = i < 0 ? this.prev : int16[i];
      out[k++] = Math.round(a + (int16[i + 1] - a) * f);
      p += step;
    }
    this.pos = p - n;
    this.prev = int16[n - 1];
    return out.subarray(0, k);
  },
};
Проверка: один и тот же сигнал прогнали целиком и нарезали на куски случайной длины. Максимальная разница — ноль.
Это подтверждает только то, что границы чанков не меняют результат. Качество самого пересчёта — отдельный вопрос: полноценного фильтра перед понижением частоты здесь нет, поэтому составляющие выше 8 кГц могут создавать искажения в оставшемся диапазоне. Проблему стыков так закрыли, качество пересчёта ещё есть куда улучшать.
Ключ сервиса в браузер не попадает. Страница просит у нашего сервера короткоживущий токен сессии через POST /voice/avatar-session. Сервер проверяет origin — источник запроса — и ограничивает выдачу: 6 токенов в час на IP и 30 в час всего.
Если получить токен или запустить видео не удалось, страница возвращается к голосовому режиму. На запрос токена отведено восемь секунд, на вызов запуска SDK — пятнадцать. Важная деталь: успешный запуск SDK ещё не означает, что появился первый кадр. В скрытом видеорежиме показывается строка с причиной ошибки, а голосовой звонок продолжается. Лицо здесь украшение, а не условие разговора.
У Anam есть ещё две важные команды. После отправки последнего аудиофрагмента реплики вызываем endSequence(). При перебивании — interruptPersona() и тот же endSequence(): первая останавливает текущую речь аватара, вторая закрывает последовательность входного звука. Конец отправки аудио при этом не означает, что аватар уже закончил его проигрывать.
Сравнивал то, что удалось запустить на моих аккаунтах: лицо прошлого поколения Simli и Anam Cara-4. Это выбор сервиса под мою задачу, а не сравнение лучших моделей обоих производителей.
Создание лица нового поколения Simli в моём аккаунте вернуло 403 с сообщением о лимите GS Faces, поэтому лицо сделали через эндпоинт прошлого поколения. Для обоих сервисов использовали один исходный портрет, один голос и одну страницу.
Simli — прошлое поколение | Anam Cara-4 | |
|---|---|---|
Полученный кадр | 512×512 | 768×1152, портрет |
Моё впечатление от мимики | Губы двигаются, остальной мимики мало | Моргает, улыбается, видны зубы, наклоняет голову |
Создание своего лица | Из фото через API прошлого поколения | Из одного фото, после создания доступно пробное видео |
Со скоростью подключения чуть не сравнил разные вещи. В одном прогоне Simli первый кадр зафиксировали примерно через 11 секунд после статуса «Соединяюсь с видео…». У Anam статус сменился через 0,9 секунды, но картинка появилась в журнале только через 2,7 секунды. Если смотреть на статус, получается одна скорость, если на кадр — другая. Поэтому общей строки «время подключения» в таблице нет: одинаковую серию замеров до первого кадра я не проводил.
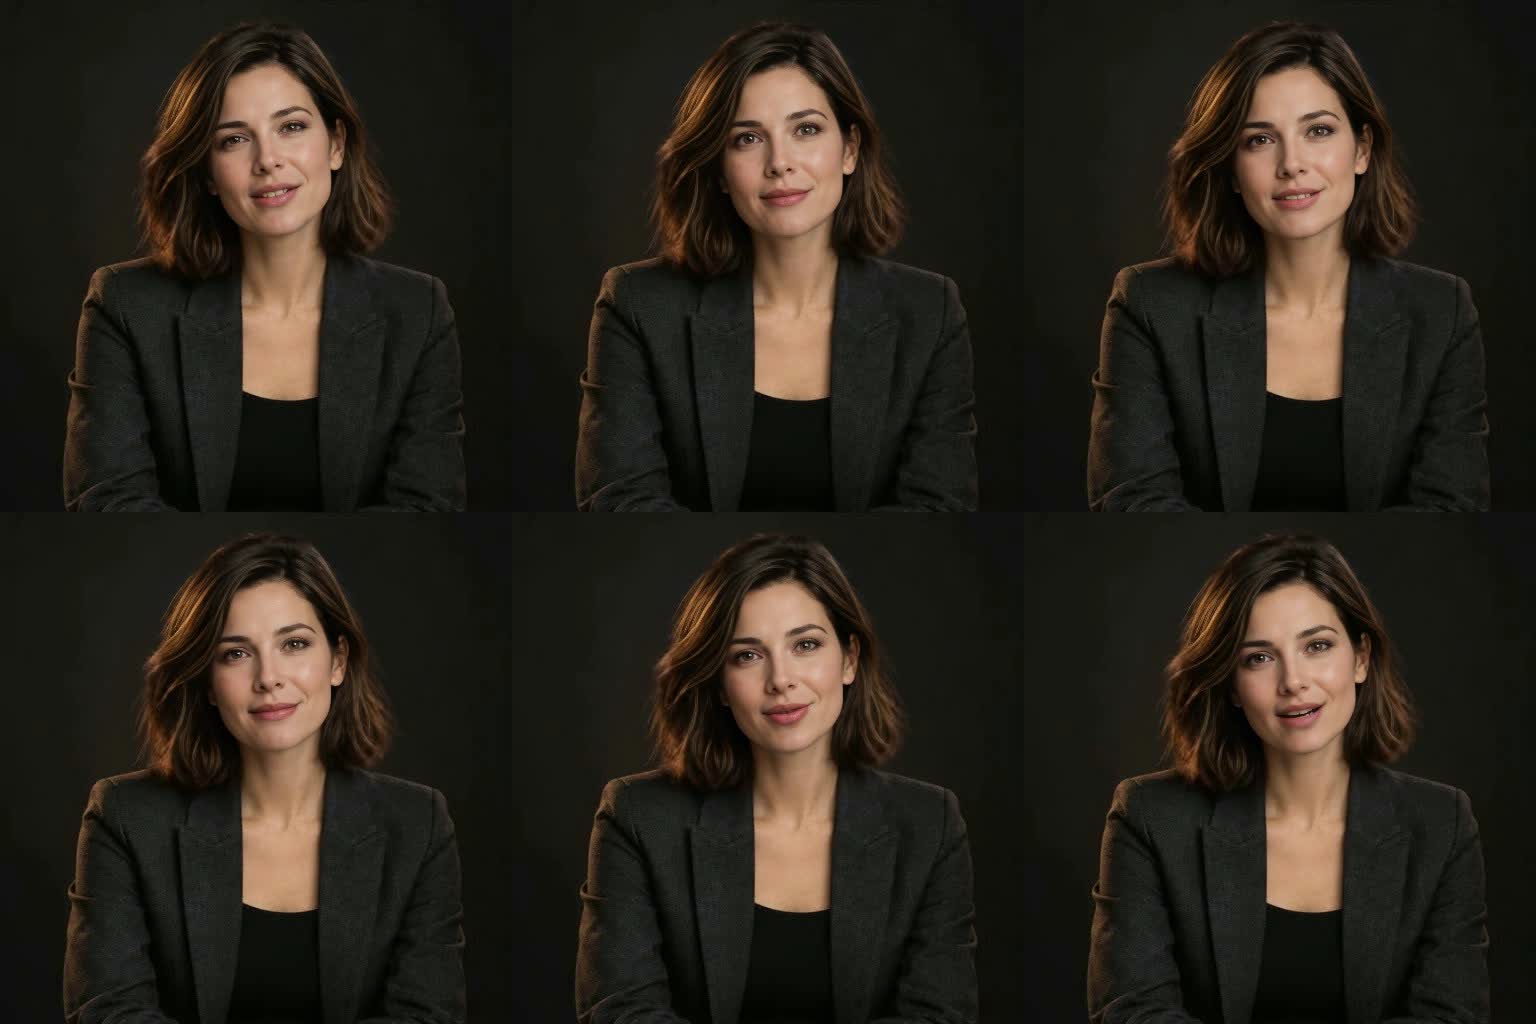
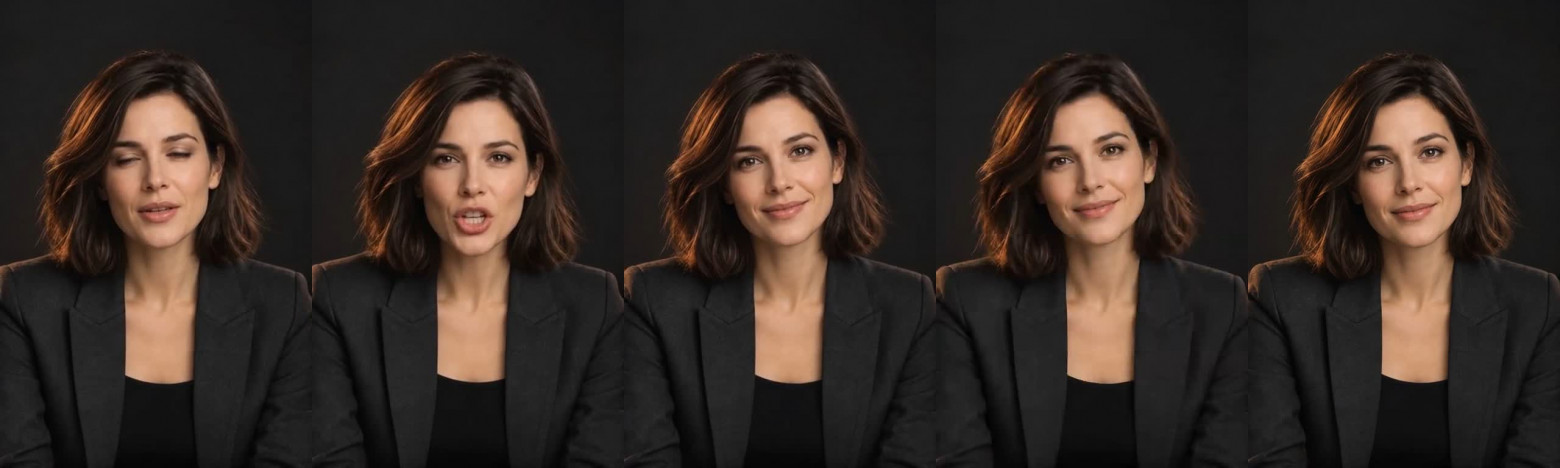
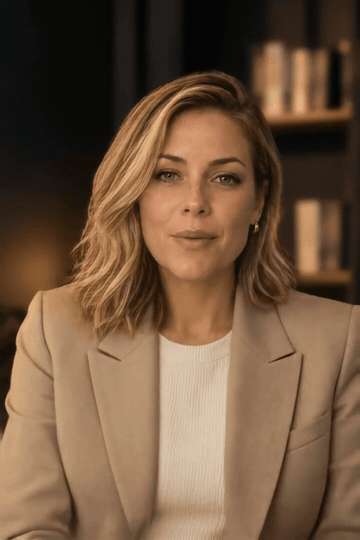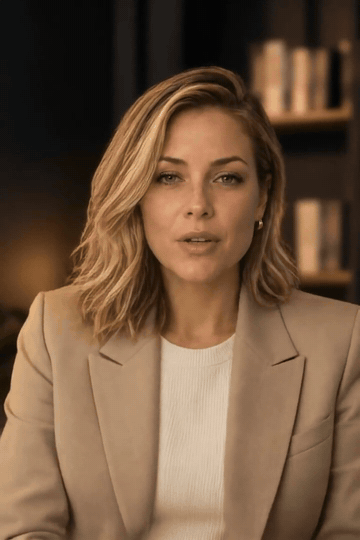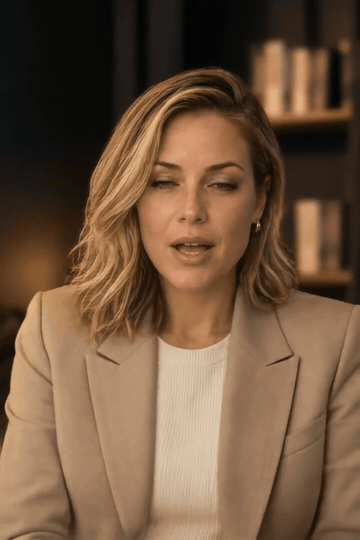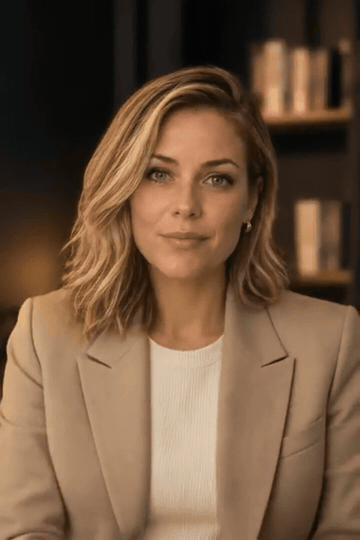
Для меня ожидание после нажатия «позвонить» — важная часть впечатления, но окончательно выбор решила картинка: у Anam лицо живёт, у Simli — говорит.
Дальше начались детали, которые пришлось проверять на своей связке.
Звук играет видеоэлемент. В нашем подключении Simli звук воспроизводился через отдельный <audio>. У Anam звук и картинка воспроизводятся одним элементом <video>, поэтому его нельзя оставлять muted — иначе лицо говорит молча. Первый прогон у меня был немым.
Разрешение на старте. В первых сессиях видео начиналось с 384×576 и примерно через семь секунд переходило на 768×1152. Опция sessionOptions.videoQuality: "high" запрашивает высокий стартовый профиль качества. В наших звонках это помогло, но гарантией не стало: на записи ролика низкое разрешение встречалось и с ней. Поэтому проверяем фактически полученный кадр.
800 мс звука до генерации кадров. Anam нужно получить 0,8 секунды аудио, прежде чем начать рисовать. Это длительность звука, а не обязательно 0,8 секунды ожидания по часам.
В одном замере в браузере 7,6 секунды речи пришли по WebSocket меньше чем за 0,1 секунды между первым и последним чанками. Длительность звука считали по числу байтов PCM16 и частоте 24 кГц. То есть звук может приходить намного быстрее, чем проигрывается.
Но до первого чанка пришлось ждать: от события окончательной расшифровки пользователя прошло 1,73 секунды. Быстрая передача готового звука не означает мгновенного ответа. И это замер на входе браузера: дальше звук ещё нужно передать в Anam, сгенерировать кадры и получить их обратно.
Микрофон не должен слышать Айку. Отправили последний чанк — не значит, что Айка договорила. Для каждого отправленного куска страница берёт более позднее из двух времён — текущий момент или уже рассчитанный конец очереди — и прибавляет длительность этого куска. После окончания отправки реплики ждёт до расчётного конца очереди плюс 1,3 секунды.
Это расчёт по отправленным сэмплам, а не подтверждение от видеоплеера. Запас помогает учесть задержку, но при необычно долгой доставке может оказаться недостаточным.
На телефоне, пока Айка говорит, микрофон не передаёт звук на сервер, иначе он ловит её голос из динамика. Это компромисс: на телефоне разговор идёт по очереди, голосовое перебивание остаётся для компьютера.
На компьютере микрофон передаёт звук во время активного звонка и при речи Айки. Когда Yandex Realtime сообщает о начале речи пользователя, наш сервер отправляет браузеру barge_in, а страница останавливает текущую речь аватара.
Занятый слот сессии. На нашем бесплатном тарифе была доступна одна одновременная сессия. После падения браузера слот некоторое время оставался занятым, и следующая попытка получала Concurrency limit reached.
Для диагностики пригодился GET /v1/sessions/concurrency: он даёт оценку занятых слотов ещё до попытки подключения. Следующая сессия от этого не получает гарантию старта, но хотя бы понятно, почему не стоит долбиться в занятую дверь.
«Стоп» во время подключения. Человек нажал «позвонить», передумал и нажал «стоп», пока видео ещё подключается. Если позднее завершение подключения не обработать, можно оставить ненужную сессию.
Для управления такими переходами ввели счётчик поколений videoGen: каждый старт и стоп меняет его значение. Асинхронная операция запоминает поколение, в котором началась, и перед изменением состояния проверяет, актуально ли оно ещё.
Самое интересное оказалось в обработке ошибки. Первая версия при сбое подключения просто гасила видео. Если человек успевал остановить звонок и начать новый, ошибка старой сессии гасила лицо уже нового разговора. Поймали на чтении диффа, до первого запуска.
Здесь важны две отдельные вещи: устаревшая операция не должна менять новый звонок, а её собственное соединение нужно закрыть. Одного return после проверки номера поколения для этого недостаточно.
Аватар регистрируем до подключения, а по «Стопу» вызываем у него stopStreaming(). Проверка поколения в обработчике ошибки защищает новый звонок от сбоя старого.
Но при проверке перед публикацией нашлась незакрытая гонка. В используемом SDK Anam 4.27.1 вызов stopStreaming() ничего не делает, если внутренний клиент соединения ещё не создан. Если в этот момент выполняется запрос на создание сессии, его поздний ответ может создать клиент уже после «Стопа».
Этот порядок воспроизвели локально на методах SDK с имитацией ответа сервера. Защита нового звонка работает, а ранняя отмена старого осталась незакрытой. В статье я сначала собирался написать, что со «Стопом» разобрались. Хорошо, что полезли проверять.
iPhone не пускал видео. В Safari выглядело так: «Соединяюсь с видео…», обрыв, разговор продолжается голосом.
Рабочая гипотеза была связана с правилами автовоспроизведения: поток Anam приходит уже после нажатия, запроса разрешения на микрофон и получения токена. Попробовали заранее вызвать play() на том же видеоэлементе прямо из обработчика кнопки. Для этого временно подавали в него поток с canvas и снимали muted. Звука в такой заглушке нет — canvas создаёт только видеодорожку.
После изменения 16 октября проверял свой iPhone в Safari через VPN. Прошли две сессии примерно по 23 и 26 секунд — их длительности сохранились в журнале Anam. Но исходную ошибку play() не зафиксировали, поэтому объяснение через автовоспроизведение осталось гипотезой. Правка помогла в моём прогоне; универсальным рецептом для Safari я её пока не считаю.
Почему проверяли через VPN — ниже.
Первый живой разговор с лицом раздражал длинной паузой перед ответом. С лицом, которое смотрит на тебя и молчит, ожидание ощущается тяжелее, чем без него.
Начал с порога тишины: в настройках стояли 2,2 секунды. Столько детектор голосовой активности, VAD, ждёт после обнаруженного окончания речи, прежде чем завершить реплику.
Общую задержку хотелось разложить на ожидание VAD, ответ модели и запуск аватара. Но для этого нужна единая шкала времени. Отдельные оценки легко сложить так, что одно ожидание попадёт в сумму дважды. Надёжного сравнения полной паузы до и после правки у меня пока нет.
Длинный порог мы поставили сознательно: люди формулируют мысль с паузами и диктуют телефон группами цифр, а Айка их перебивала.
Сама идея менять порог не новая. На Хабре уже разбирали его выбор по правилам русского синтаксиса. У меня задача уже: сохранить паузы при диктовке контакта и не держать такое длинное ожидание весь разговор.
Поэтому длинный порог включается заранее, когда Айка просит номер, ещё до ответа человека. Когда диктовка закончена, возвращается обычный.
У телефонного моста Айки такая логика уже была, на сайт её просто не перенесли. Теперь перенесли:
в обычном разговоре порог 1500 мс, на время диктовки — 2200 мс;
длинный порог включается при просьбе назвать контакт и при получении части номера;
обычный возвращается, когда номер собран, буфер диктовки закрыт или прошло 30 секунд с последнего продления окна.
Настройки отправляем через session.update в действующую сессию, без переподключения. Ниже 1,5 секунды пока не опускали: на прежних пробах короткий порог обрывал живые фразы.
Отдельная история с тестом. Для проверки сделали три сценария с имитацией ответов Яндекса. Потом специально убрали из кода подъём порога — хотелось убедиться, что тест заметит поломку.
Первая версия всё равно прошла: ответ на просьбу о контакте попадал в буфер диктовки, и порог поднимался другой веткой. Проверяли не то. Переписали на условие «порог поднят ДО ответа человека». Теперь без нужной логики тест падает.
Обычный порог ожидания уменьшили на 700 мс, для диктовки оставили прежний. Сколько выиграл весь разговор до первого слышимого слова, ещё нужно измерить отдельно.
Приход расшифровки для этого не годится. Браузер получает окончательный текст событием user_text, звук — отдельными pcm_chunk. А после получения звука его ещё нужно проиграть. Для человека пауза заканчивается тогда, когда он услышал ответ.
Айке лицо досталось готовое. Для второго персонажа, администратора студии Евы, я застрял надолго.
Сначала перебирал студийные портреты на пустом графитовом фоне: менял лица, причёски, свет. Получалась «стоковая блондинка» с глянцевой кожей. Потом Codex по ТЗ сделал ещё шесть типажей. Фальшь оставалась.
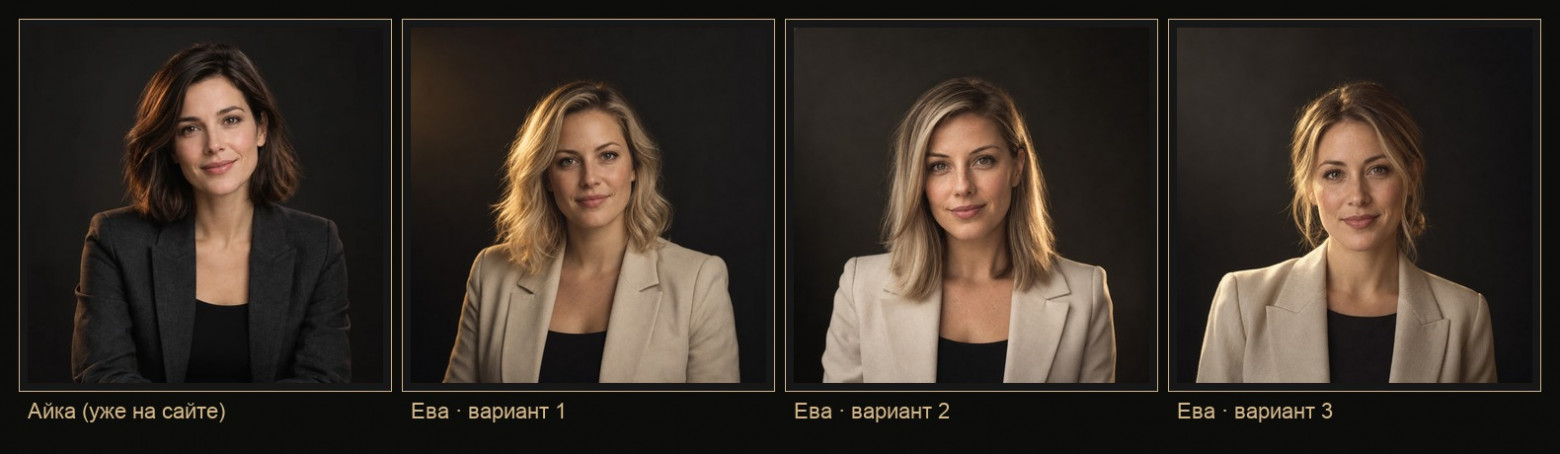
Перелом случился, когда за спиной появился интерьер: тёплые лампы, полки, растения, размытый дальний план. Для образа сотрудника студии это оказалось убедительнее пустого фона. До этого я видел каталог, теперь — человека на рабочем месте.
Для другого персонажа пустой фон мог бы подойти. Anam вообще рекомендует простой фон. Я остановился на спокойном интерьере без лишних деталей — под нашу задачу он работал лучше.
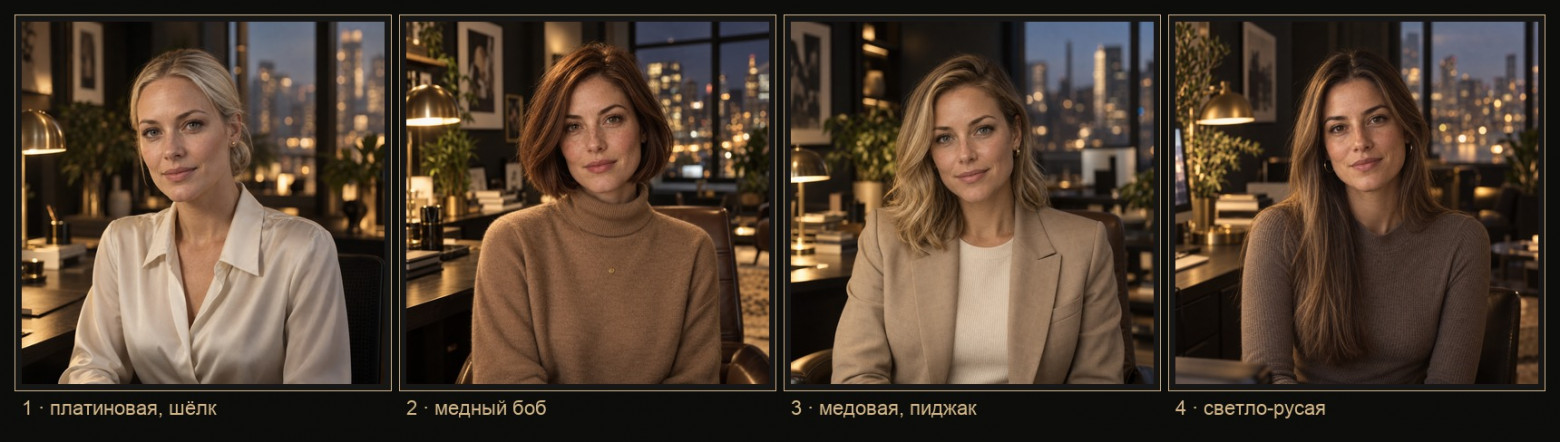
Новая беда: генератор нарисовал за спиной небоскрёбы, а это совсем не тот образ студии, который мне нужен. Просил поправить фон — каждый раз получалось «похожее, но не наше». Сработал ручной путь:
Взяли готовый интерьер в нашей стилистике и генератором убрали людей.
Еву вырезали средствами macOS Vision — VNGeneratePersonSegmentationRequest с уровнем .accurate. Край маски немного сузили и смягчили, чтобы убрать ореол вокруг волос.
Собрали портрет и фон.
Первая склейка вышла смешной: в кадр фона попал стол с переднего плана, и за спиной у Евы выросли гигантская кружка и ноутбук. Масштаб предметов выдаёт монтаж мгновенно. Фон взяли только выше столешницы и размыли под портретный объектив.
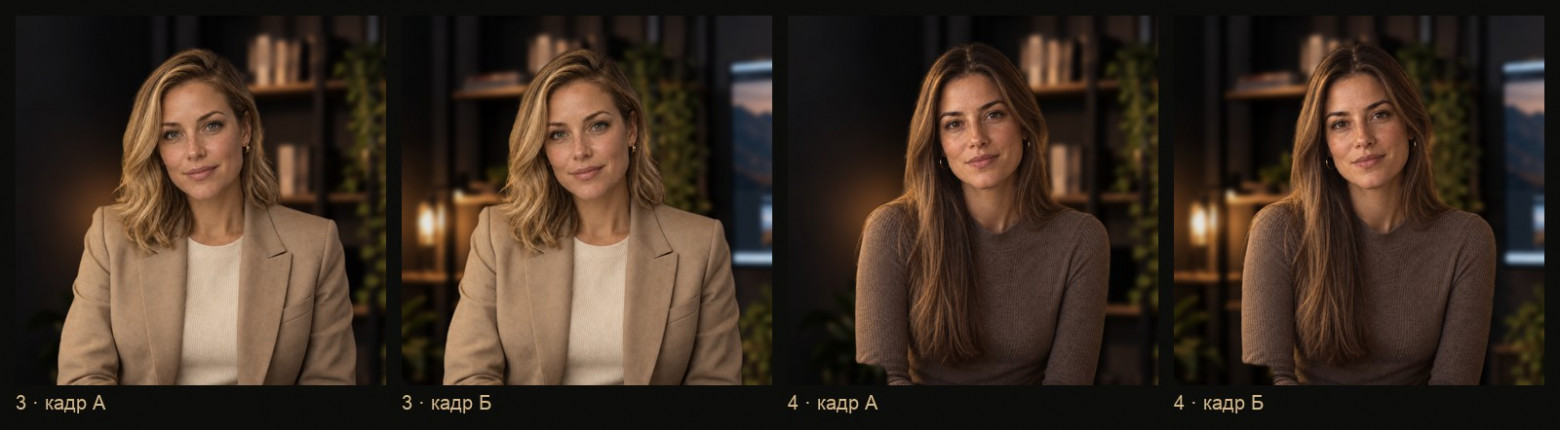
Последний шаг — разрешение. В рекомендациях для Cara-4 указан квадратный исходник от 1152×1152. На наших портретах чистое увеличение Real-ESRGAN ×4 делало кожу слишком гладкой. Лучше выглядела смесь нейросетевого увеличения с обычным масштабированием и повышением резкости, плюс немного зерна.
У Айки голос из Realtime, а для Евы выбирали отдельную озвучку.
У Яндекса есть семейство LiveTTS: женские голоса sofia, vera, irina, мужские vasily, sergey, denis. Наборы амплуа у них разные. В SpeechKit API v3 модель выбирается через "model": "livetts", голос и амплуа передаются отдельными элементами hints.
Что встретилось на практике:
запрос к старому v1 tts:synthesize с голосом LiveTTS вернул 400 Unsupported voice;
наш запрос с длинным текстом в v3 тоже вернул 400;
для ролика текст разбили на предложения, синтезировали отдельно и склеили с короткими паузами.
Разбиение по предложениям — наш выбранный способ, а не единственная возможность API для длинного текста.
В Realtime для голосового агента с LiveTTS есть speech-realtime-max-tts-live. Модель speech-realtime-tts-live решает другую задачу: синтезирует текст без языковой модели и аудиовхода. Живую Айку в рамках этой работы на них не переводили.
Из семи вариантов озвучки одной фразы выбрали vera в амплуа casual. Во фразе «обзвоны отсеиваю» синтез стабильно ошибался с ударением. Разметкой лечить не стали, просто переписали фразу.
Ролик Евы записали через тот же движок анимации, который используется в живом звонке. Запись делали через MediaRecorder прямо с video.srcObject: видео и звук вместе, WebM с VP9 и Opus, дальше — обработка в ffmpeg.
В нашей схеме до подачи аудио не появлялись нужные для записи кадры. Поэтому поток предварительно «будили» секундой тишины, чтобы ролик не начинался с чёрного экрана.
Ролик выложили, и тут посыпалось.
Асимметричные лацканы. На исходном портрете один лацкан пиджака отличался от другого — ошибка генератора, которую я пропустил. Аватар повторял её в каждом кадре. Исправили маской только лацкан, пересоздали аватар, перезаписали тем же голосом.
Рассинхрон звука и губ. В одном дубле звук заметно отставал от артикуляции. Подобрали сдвиг примерно на 0,23 секунды и проверили несколько начал фраз после пауз.
Здесь пришлось разделить две задачи. Можно сравнить исходную озвучку с записанным звуком и найти сдвиг между ними. Но это ещё не доказывает, что звук совпадает с движениями губ. Для этого нужна отдельная проверка видео.
Ориентироваться на одно открытие рта ненадёжно: видимое движение зависит от произносимого звука. Поэтому смотрели несколько фраз, а не подгоняли весь ролик под один момент.
Лишнее «и». В записанной дорожке появилось «…на звонки И, а я», хотя в исходной озвучке этого звука нет. На каком этапе он возник, мы не установили.
Теперь под видео кладём исходную чистую озвучку. Её положение относительно записанного звука находим кросс-корреляцией — по сходству сигналов при разных временных сдвигах. Совпадение с губами после этого проверяем отдельно, глазами.
В одном дубле получили смещение 14 794 сэмпла при 48 кГц — примерно 0,308 секунды. Повторный расчёт по исходным файлам дал то же значение. На позднем участке осталась разница около 10 мс. Один общий сдвиг не обязательно выравнивает всю запись идеально, поэтому после замены звука ролик всё равно нужно просмотреть целиком.
И два наблюдения без красивого решения.
В отдельных записях получали 384×576 даже с опцией высокого качества, поэтому каждый дубль проверяли по разрешению.
Первое слово после тишины аватар иногда отыгрывал вяло. После «разогрева» — короткого фрагмента речи перед записью — начало в некоторых дублях выглядело лучше. Но мимика каждый раз новая, это лотерея. Пробовал склеить первое слово из другого дубля — шов видно, отказался.
Так что итоговый ролик — подготовленная запись: выбранный дубль, исходная озвучка, поправленная синхронизация. Он показывает качество анимации после подготовки. Задержку и стабильность живого разговора по нему оценивать нельзя.
До проверки с телефона всё выглядело обнадёживающе. С российского VPS без прокси отвечал api.anam.ai, был доступен connect-eu.anam.ai. В сетевой документации указан ещё connect.anam.ai, но при нашей проверке это имя не разрешалось ни через 1.1.1.1, ни через 8.8.8.8. Причину такого ответа DNS мы не установили.
По документации Anam основной медиапуть использует UDP 3478, резервный — TURN через TLS на TCP 443. TURN — сервер-посредник для передачи медиа, когда прямое соединение не получается.
Но доступность API с VPS не проверяет путь от телефона до видеосервиса.
16 октября на моём iPhone через мобильный интернет без VPN сессия создавалась, но в журнале Anam завершалась со статусом CLOSED_NEVER_JOINED и нулевой длительностью соединения. Через VPN тот же телефон разговаривал с лицом. В журнале две состоявшиеся сессии идут перед неудачной попыткой.
Выдача токена через наш сервер проходит, дальше соединение не устанавливается. На каком именно этапе — из одного статуса не видно. Тем более по нему нельзя определить, кто и что блокирует.
Тут пригодилось правило «лицо — украшение»: в этой проверке страница вернулась к голосовому режиму.
Поведение в других сетях я пока не установил, но для решения хватило и этого: видеорежим всем посетителям не открываю. Следующие возможные эксперименты — принудительный TURN и передача медиа через свой сервер. Помогут ли они в этой сети, ещё предстоит проверить.
Попутно сработал собственный лимит: на тестах я упёрся в 6 токенов в час на IP и получил 429. Защита работает и против меня.
К моменту подготовки статьи получилось следующее:
обычный порог тишины на сайте уменьшили с 2200 до 1500 мс, для диктовки оставили 2200 мс;
видеорежим Айки оставили скрытым, ссылку даю точечно;
для Евы сначала записали ролик тем же движком, что и живой звонок. Уже после подготовки статьи заменили его записью HeyGen Avatar IV: для заранее записанного ролика реальное время не нужно, а рендер за пару минут даёт заметно более живую мимику. Живой разговор это не заменяет — ответить человеку запись не может;
проблемную для синтеза фразу переписали.
Полную задержку ответа до и после изменения порога ещё нужно сопоставить по одинаковой методике. Доступность видео — проверить в других сетях, а раннюю отмену подключения — исправить. Красивое лицо на моём экране этих вопросов не закрывает.
С лицом я несколько раз правил не то: перебирал внешность, хотя для нужного впечатления не хватало обстановки. С тестом вышло похоже: он проходил даже после удаления нужной логики. После этой истории я отдельно проверяю две вещи — работает ли результат и способна ли моя проверка заметить, когда он сломается.