218 КБ переводов в каждой странице: что прячется в payload Nuxt-приложения
- суббота, 7 ноября 2026 г. в 00:00:05
Я фронтенд-разработчик в BIGPLAY — киберспортивной платформе на Nuxt. Недавно разбирался, почему главная страница весит больше полумегабайта HTML, и нашёл там весь словарь переводов сайта — 2271 строку, 218 КБ. Он лежал в каждой странице, хотя на главной показывается от силы несколько десятков строк.
В статье расскажу, откуда он там взялся, как мы его оттуда убрали, почему не стали оптимизировать дальше — и что показала проверка 36 известных сайтов на Nuxt. Спойлер: это частая история.
Когда Nuxt рендерит страницу на сервере, браузер получает готовый HTML с текстом. Но потом Vue должен «ожить» на клиенте — пройти гидратацию — и для этого ему нужны те же данные, что были у сервера. Чтобы не запрашивать их заново, Nuxt кладёт их прямо в HTML:
<script type="application/json" id="__NUXT_DATA__">[ …данные… ]</script>
Туда попадает всё из useState, useAsyncData/useFetch и сторов Pinia.
Проблема в том, что этот тег не видно: страница выглядит нормально, Lighthouse ругается на «большой HTML», но не говорит, что именно его раздуло. А стоит он дорого:
приезжает при каждой полной загрузке — обновление, новая вкладка, переход из поисковика, повторный визит;
HTML браузер не кэширует, так что вчерашняя копия не поможет;
до гидратации браузер должен скачать и разобрать весь payload.
При переходах внутри сайта через NuxtLink новый HTML не загружается и состояние уже в памяти, поэтому там проблема не видна — и это ещё одна причина, почему её легко не заметить.
Схема у нас была такая: переводы приходят из внешнего сервиса, серверный middleware забирает словарь текущего языка, а плагин кладёт его в useState, чтобы vue-i18n получил его и на сервере, и на клиенте.
// было: весь словарь — в состояние, а значит в payload
const translations = useState('translations', () => ({}))
if (import.meta.server) {
  translations.value = useRequestEvent()?.context.translations
}
Работает. Только useState сериализуется в payload целиком — на каждой странице. Живой прод на момент находки: HTML главной 658 КБ, из них payload — 271 КБ.
Идея простая: словарь меняется редко, значит, его можно отдать отдельным файлом и разрешить браузеру кэшировать его надолго.
Версия по хешу содержимого. Сервер считает sha1 словаря и отдаёт его по адресу /i18n/ru.<хеш>.json с cache-control: immutable на год. Тот же словарь — тот же адрес, поэтому перезапуск сервера кэш не сбрасывает.
В payload — только версия, 12 символов вместо 218 КБ.
Preload в <head>, чтобы браузер начал качать словарь вместе с HTML, а не после загрузки JS. Важная деталь: crossorigin="anonymous", иначе preload не совпадёт с fetch() и файл скачается дважды.
Сервер по-прежнему рендерит с полным словарём, поэтому для поисковиков HTML не изменился — тексты на месте.
Пара граблей, на которые чуть не наступили:
Не класть файл под /api/. У нас /api/ закрыт в robots.txt. Googlebot при рендеринге JS не смог бы скачать словарь, и в его снимке страницы вместо текста оказались бы ключи. Перенесли в /i18n/.
Кэш страниц переживает обновление переводов. HTML из серверного кэша может ссылаться на старую версию словаря. Если запрошена неизвестная версия, отдаём актуальный словарь с no-store — иначе под старым адресом навсегда залип бы новый текст. Последние несколько версий держим в памяти, чтобы отдавать ровно ту, которой страница отрисована.
Результат на прод-сборке (gzip):
Страница | HTML было → стало | payload было → стало |
|---|---|---|
Главная | 112 → 59 КБ | 66 → 12 КБ |
/en | 96 → 58 КБ | 50 → 12 КБ |
Список турниров | 101 → 48 КБ | 56 → 3 КБ |
Честная оговорка: на первом заходе выигрыш почти нулевой — словарь (~50 КБ gzip) всё равно качается, просто отдельным файлом. Выигрыш на повторных заходах: там словарь берётся из кэша, 0 байт по сети.
Логичный следующий шаг — отдавать каждой странице только её переводы. Я собрал карту «какой слой какие разделы словаря использует» и передумал:
общие компоненты (шапка, футер, модалки) есть на каждой странице и тянут разделы на 68–82% словаря;
если резать по отдельным ключам, страницам нужно 21–32%, но статически в коде находится лишь 58% ключей — остальные подставляются динамически, и любой промах покажет пользователю tournament_page.xxx вместо текста;
главное: словарь (53 КБ gzip) грузится параллельно с JS, а JS на главной — 317 КБ gzip. Интерактивной страница становится, когда загрузится JS, а не словарь. Уменьшение словаря время до интерактива не меняет.
Первый шаг собрал почти весь выигрыш, второй дал бы копейки при реальном риске. Иногда лучший результат оптимизации — вовремя остановиться.
Мне стало интересно, только у нас так или нет. Я взял сайты из официальной витрины nuxt.com/showcase и проверил payload их главных страниц (ноябрь 2026, один снимок, без входа в аккаунт). Из 51 сайта разобрать получилось 36: часть ещё на Nuxt 2, на некоторых нет серверного рендеринга.
медиана payload — 93 КБ, это 29% HTML;
у 17 из 36 больше 100 КБ, у 6 — больше 500 КБ (на этих порогах Nuxt DevTools теперь показывает жёлтое и красное предупреждение).
Самые частые «тяжеловесы» — словари переводов (у нескольких крупных e-commerce брендов это 120–280 КБ строк интерфейса прямо в payload главной) и данные CMS.
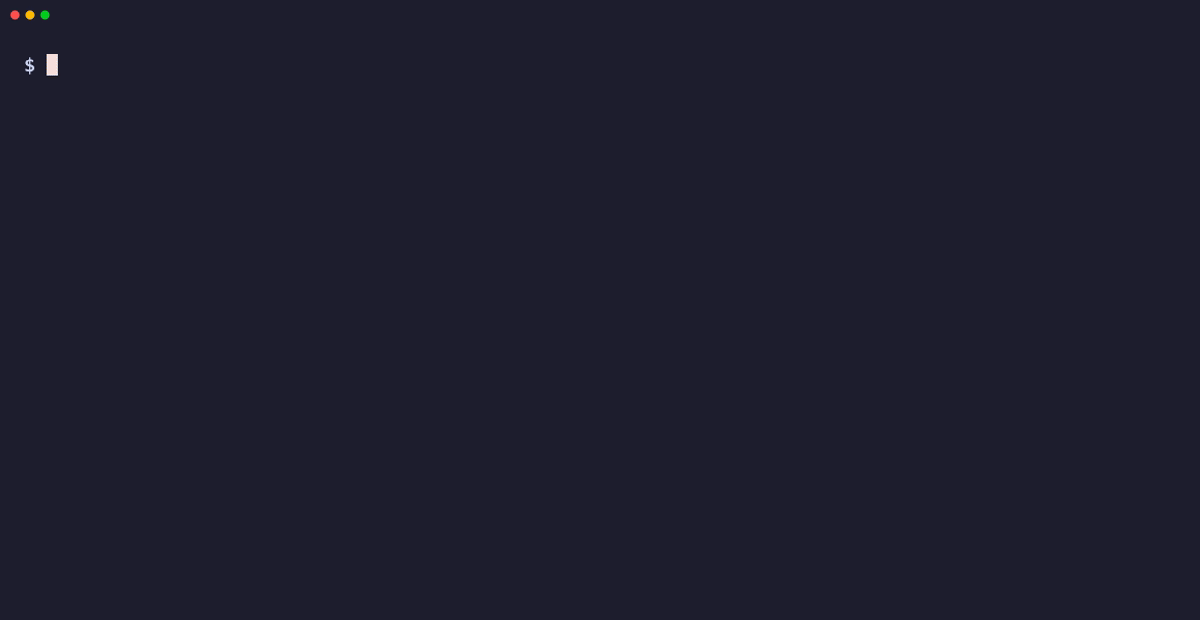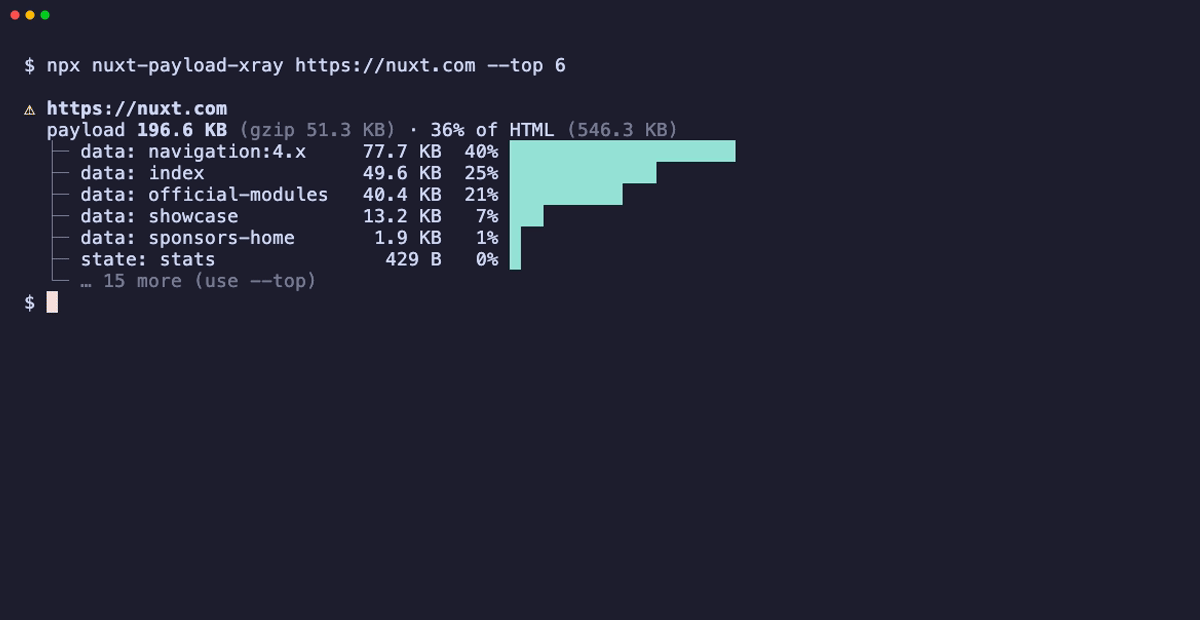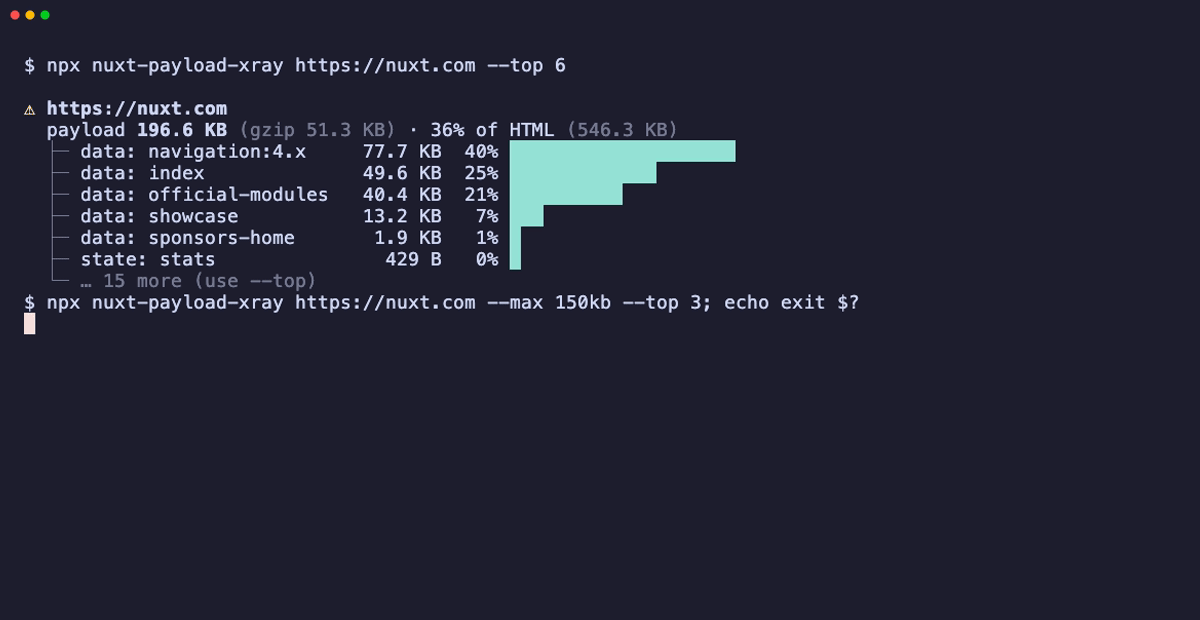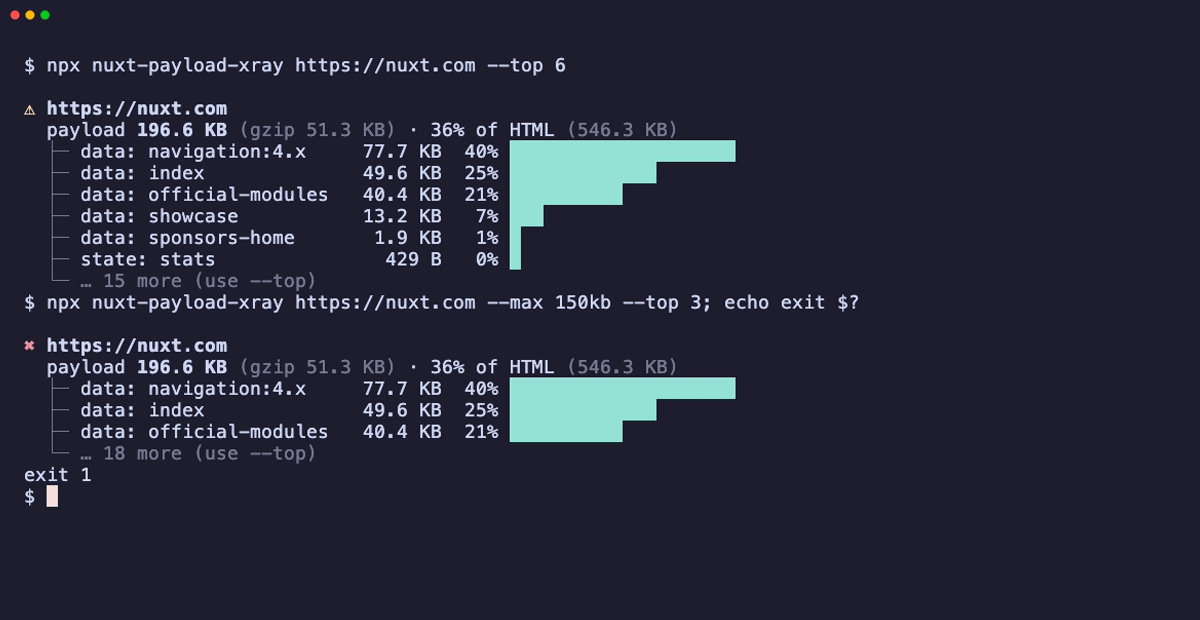
Но большой ключ — не обязательно ошибка. На главной nuxt.com самый тяжёлый ключ — navigation:4.x, 77,7 КБ: это всё меню сайта, 429 пунктов. Скорее всего, оно нужно поиску по Ctrl+K, который мгновенно ищет по всей документации. Тогда это осознанная цена за быструю функцию.
Правило, к которому я пришёл: большой вес + на странице используется мало = ошибка. Большой вес + используется всё = нормальная цена.
Пока разбирался, написал скрипт, который смотрит payload любой страницы по URL. Потом оформил его в небольшой CLI:
npx nuxt-payload-xray https://nuxt.com
⚠ https://nuxt.com
  payload 196.6 KB (gzip 51.3 KB) · 36% of HTML (546.3 KB)
  ├─ data: navigation:4.x     77.7 KB  40% ████████████████████
  ├─ data: index              49.6 KB  25% █████████████
  ├─ data: official-modules   40.4 KB  21% ██████████
  └─ … 18 more (use --top)
А вот наш bigplay.gg после исправления:
✔ https://bigplay.gg
  payload 55.9 KB (gzip 15.7 KB) · 29% of HTML (191.6 KB)
  ├─ data: home-page-ru            54.3 KB  97% ████████████████████
  ├─ pinia: tournamentsPageStore     172 B   0% █
  ├─ pinia: translationState         132 B   0% █
  └─ … 19 more (use --top)
Почти весь payload теперь — данные самой главной (турниры, баннеры), то есть то, что на ней действительно показывается. Словаря переводов в списке нет.
Он показывает размер каждого ключа data / state / pinia, а с флагом --max возвращает код 1 — можно поставить в CI против задеплоенного превью:
npx nuxt-payload-xray "$PREVIEW_URL" --max 150kb
Как он считает. Nuxt сериализует payload форматом devalue: это плоский массив, где значения ссылаются друг на друга по индексу, а нулевой элемент — корень.
0: { state: 1, data: 3 }
1: { $slang: 2 }
2: "ru"
3: { user: 4 }
4: { name: 5, city: 6 }
5: "Ann"
6: "Almaty"
Повторяющиеся значения хранятся один раз — отсюда экономия. Инструмент идёт по ссылкам от каждого ключа и складывает байты всего, до чего дошёл.
Чем отличается от того, что уже есть:
Nuxt DevTools недавно научились показывать размеры по ключам на вкладке Payload (PR #1159) — но это dev-режим, у себя локально;
nuxt-payload-analyzer проверяет _payload.json при nuxt generate;
nuxt-payload-xray смотрит любой задеплоенный SSR-сайт по URL, без кода, и умеет падать в CI.
Прогоните главную и пару тяжёлых страниц: npx nuxt-payload-xray <url>.
Для каждого большого ключа спросите: сколько из этого реально показывается на странице?
useFetch(url, { pick: ['id', 'title'] }) — забирайте только нужные поля.
Большие редко меняющиеся данные (переводы, справочники, конфиги) — в отдельный кэшируемый файл, а не в useState.
Не кладите в Pinia весь ответ API, если на странице видна пара полей.
Код открыт: github.com/dadashi44/nuxt-payload-xray. Если вам интересна производительность Vue, загляните и в vue-why-render — он показывает, какие компоненты перерисовываются и почему. Буду рад обратной связи и рассказам, какой ключ оказался самым тяжёлым у вас.